- はじめに — 選択肢は実質4つになった
- 第2章 実行モデルの基本 — Lambda標準とStep Functionsの使い分け
- 第3章 新顔ふたつを深掘りする — Lambda durable functionsとManaged Instances
- 第4章 判断基準の早見表
- 第5章 システム要件からの逆引き
- 要件1:処理が15分以内に確実に終わる単発のイベント処理である
- 要件2:複数ステップにまたがる処理で、各ステップの実行状況を非エンジニア(業務部門など)も含めて可視化・監査したい
- 要件3:高頻度・短時間(数秒〜数分)のイベント処理を、複数ステップでオーケストレーションしたい
- 要件4:Python/Node.jsで実装しており、既存のLambda関数のコードベースを維持したまま、長時間の待機(人の承認待ち、外部処理の完了待ちなど)を追加したい
- 要件5:Java/Go/.NET等、Python/Node.js以外の言語で長時間ワークフローを実装する必要がある
- 要件6:LLM/AIエージェントのように、外部ツール呼び出しやユーザーからのフィードバック待ちが断続的に発生し、待機時間が数時間〜数ヶ月単位になりうる
- 要件7:GPUや特殊なコンピュート構成(大容量メモリ等)がLambda標準の制約上使えない
- 要件8:月間の呼び出し数が非常に大きく(数千万〜億単位)、稼働率が高く安定している定常ワークロードで、コストを最優先で最適化したい
- 要件9:サービスがまだ検証段階で、トラフィックの見通しが立っていない
- 第6章 まとめ — 「増えた選択肢」は「複雑になった」ではなく「精度が上がった」
- 参考文献
はじめに — 選択肢は実質4つになった
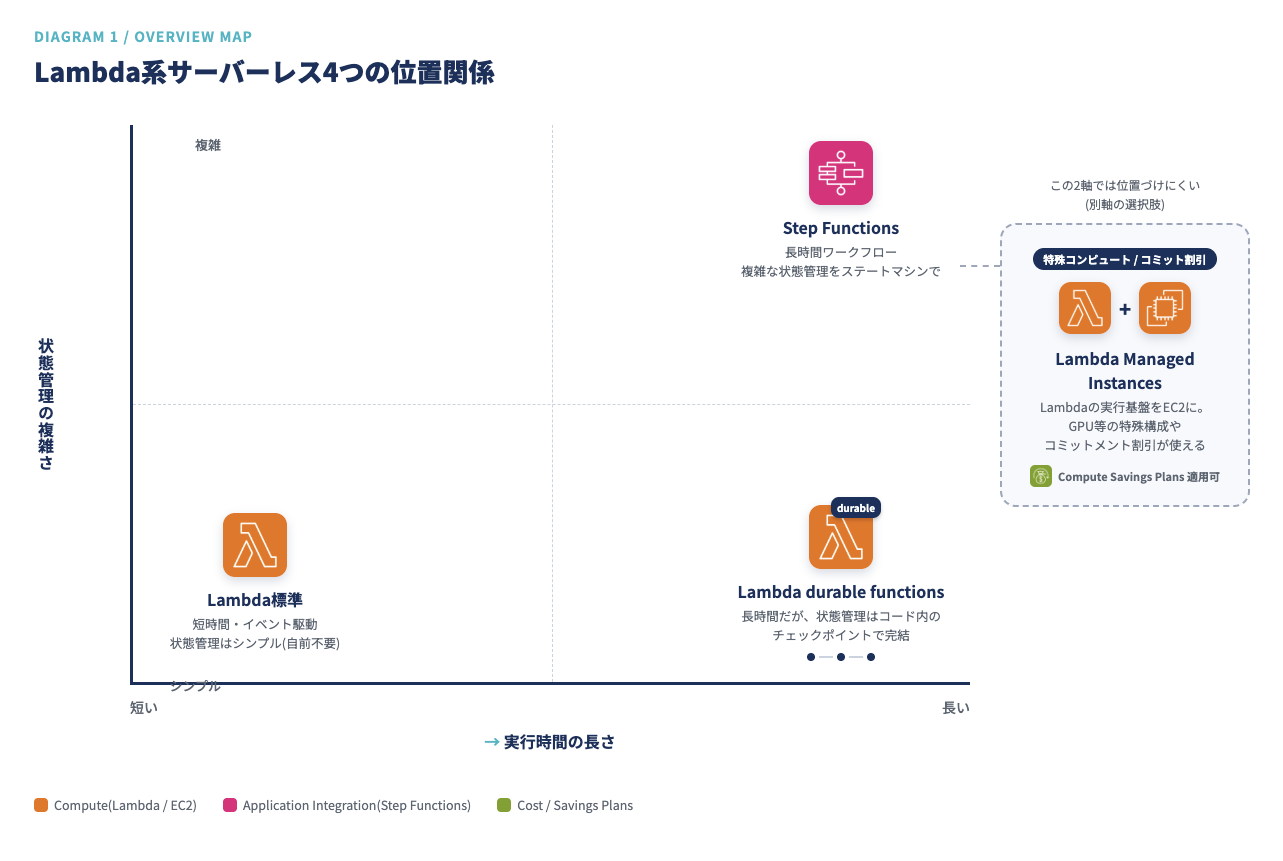
ServerlessDays Tokyo 2026に参加した。2025年11月にAWS Lambda Managed Instancesが、同年12月にAWS Lambda durable functionsがそれぞれGA(一般提供開始)し、これまで「Lambda標準かStep Functionsか」の二択でおおむね足りていたAWSのサーバーレスコンピュート選定が、実質的に4択になった。
- AWS Lambda(標準) — 従来型のイベント駆動FaaS
- AWS Step Functions — ステートマシンによるワークフローオーケストレーション
- AWS Lambda durable functions(2025年12月GA) — Lambda関数自体にチェックポイント・再開機能を持たせる新機能
- AWS Lambda Managed Instances(2025年11月GA) — Lambdaの実行モデルのままEC2インスタンス上で関数を動かす新しい実行環境
この記事は、AWS認定資格の学習中のエンジニアや、実装の意思決定をするEM(エンジニアリングマネージャー)向けに、この4つを「どういう時に選ぶべきか/選ぶべきでないか」「メリット・デメリット」「業務ユースケース」「システム要件からの逆引き」という4つの軸で整理し直したものだ。
本稿の対象範囲について:本稿はAWS Lambdaをベースにした4つの実行モデルに対象を絞る。AWS Fargate(ECS/EKS上で動くサーバーレスコンテナ実行環境)は、コンテナイメージのビルド・実行が前提で、vCPU・メモリごとの秒単位課金(1分単位の最低課金)という、Lambda系4つとは異なるコストモデル・運用モデルを持つ。実行時間の上限も設計思想もLambda系とは別物であり、同じ表・同じ判断基準で並べると誤解を招きやすいため、本稿では扱わない。コンテナベースのサーバーレスコンピュートを検討している場合は、Fargateを含む別軸での比較が必要になる。
なお本稿中の料金試算・サービス仕様の数値は、AWS公式サイト・公式ドキュメントに基づく。
第2章 実行モデルの基本 — Lambda標準とStep Functionsの使い分け
まず新顔2つの前に、土台となる2つの選択肢を整理する。
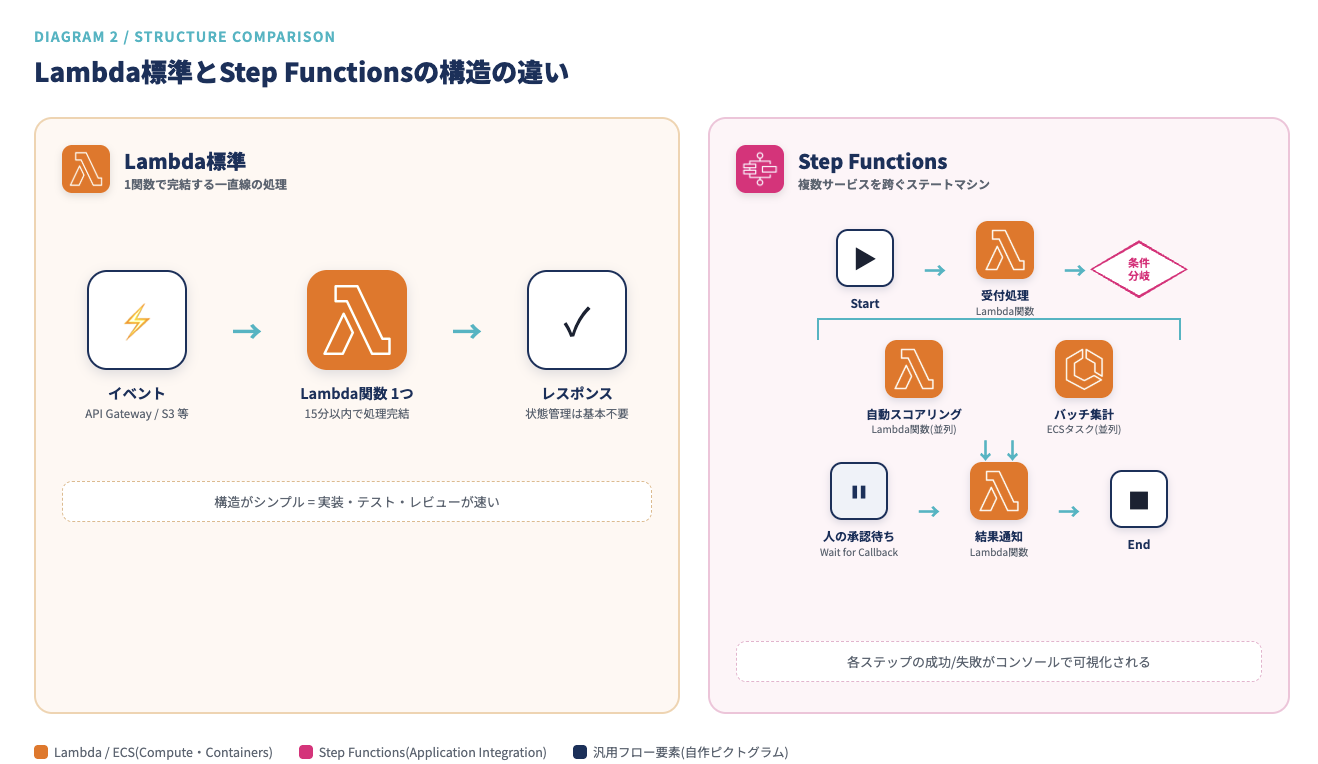
2-1. AWS Lambda(標準)
特徴
- イベント駆動のFaaS。1リクエスト1実行環境が基本で、リクエスト数とメモリ×実行時間(GB秒)に応じて課金される。
- 実行時間の上限は900秒(15分)。この制約は「短時間・イベント駆動のタスクに向いている」という設計思想そのもので、これを超える処理はAWS BatchやECS/EKSなど別サービスに逃がすことが公式にも推奨されている。
- コールドスタート、同時実行数のスケーリング(初期バーストの後は10秒ごとに最大1,000同時実行ずつ増加)など、素のFaaSとしての制約はそのまま残る。
メリット
- 実装がシンプル。関数を書いてデプロイするだけで、インフラ管理がほぼゼロ。
- 呼び出し数に応じた完全従量課金で、低トラフィック時のコストが極めて低い。
- AWSの主要サービス(S3, DynamoDB, API Gateway, EventBridge等)とのイベント連携が豊富。
デメリット
- 15分を超える処理ができない。
- 複数ステップにまたがる状態管理(リトライ、途中経過の保持、人の承認待ちなど)を自前で実装する必要がある。DynamoDBやSQSを併用した「疑似ワークフロー」を書くケースが後を絶たず、これが後述のStep FunctionsやDurable Functionsが存在する理由でもある。
選ぶべき時
- 単発のイベント処理(画像リサイズ、Webhook受信、軽量なAPIバックエンドなど)。
- 処理が1関数・数秒〜数分で完結し、複数ステップの永続的な状態管理が不要な場合。
選ぶべきでない時
- 複数ステップにまたがる長時間ワークフローで、途中経過の可視化や人の承認待ちが必要な場合。
- 実行時間が15分を恒常的に超える見込みがある場合。
業務ユースケース例
- ECサイトの注文確定時に飛ぶWebhookを受けて在庫DBを更新する。
- アップロードされた画像を複数サイズにリサイズしてS3に格納する。
2-2. AWS Step Functions
特徴
- JSON(Amazon States Language)で定義するステートマシンにより、複数のLambda関数やAWSサービス呼び出しを順序立てて実行するオーケストレーションサービス。
- Standardワークフロー:state transition(状態遷移)ごとの課金で、1,000 state transitionあたり0.025ドル。実行履歴が90日間保持され、最大1年間の実行が可能。監査ログが必要な業務フローに向く。
- Expressワークフロー:実行回数と実行時間・メモリに応じた課金(100万リクエストあたり概ね1ドル程度+実行時間分)で、高頻度・短時間のイベント処理向け。実行履歴は自前でCloudWatch Logsに出す形になる。
メリット
- ワークフローの各ステップの状態がコンソール上で可視化される。障害時にどこで止まったかが一目でわかる。
- リトライ・エラーハンドリング・並列実行・人の承認待ち(Wait for Callback)がステートマシン定義だけで表現できる。
- Lambda以外(ECS、Batch、SNS、SQS、DynamoDBなど)のAWSサービスを直接ステップに組み込める。
デメリット
- 実装言語がJSON(ASL)ベースのステートマシン定義であり、通常のプログラミング言語で書くLambda関数と比べて学習コストがある。
- Standardワークフローはstate transition課金のため、ステップ数が多いワークフローを高頻度で回すとコストが積み上がりやすい。
- ローカルでのユニットテストや、コードレビューでの差分の追いやすさはLambda単体に劣る。
選ぶべき時
- 複数ステップ・複数サービスにまたがる業務フローで、実行状況の可視化や監査ログが必要な場合。
- 人の承認を挟むワークフロー(経費承認、与信審査など)。
- Lambda以外のAWSサービス(ECS Fargateでのバッチ処理など)をオーケストレーションしたい場合。
選ぶべきでない時
- 単一のシンプルな処理で、複数ステップの可視化や監査ログが不要な場合(Lambda標準で十分)。
- コードとしてのメンテナンス性(単一言語での記述、テストのしやすさ)を最優先したい場合。
業務ユースケース例
- 与信審査フロー(書類受付→自動スコアリング→一定スコア未満は人による審査→結果通知)。
- ETLパイプライン(複数のバッチ処理をECS/Glueで順次・並列実行し、失敗時は自動リトライ)。
第3章 新顔ふたつを深掘りする — Lambda durable functionsとManaged Instances
3-1. AWS Lambda durable functions(2025年12月GA)
2025年12月2日にus-east-2(オハイオ)リージョンでGAし、同年12月18日に14リージョンへ拡大した新機能。Step Functionsのようにステートマシンを別途定義するのではなく、Lambda関数のコード自体に「チェックポイント」を挟むことで、中断・再開・長時間の待機を可能にするというアプローチを取る。対応言語はPython(3.13, 3.14)とNode.js(22, 24)。
仕組みの要点
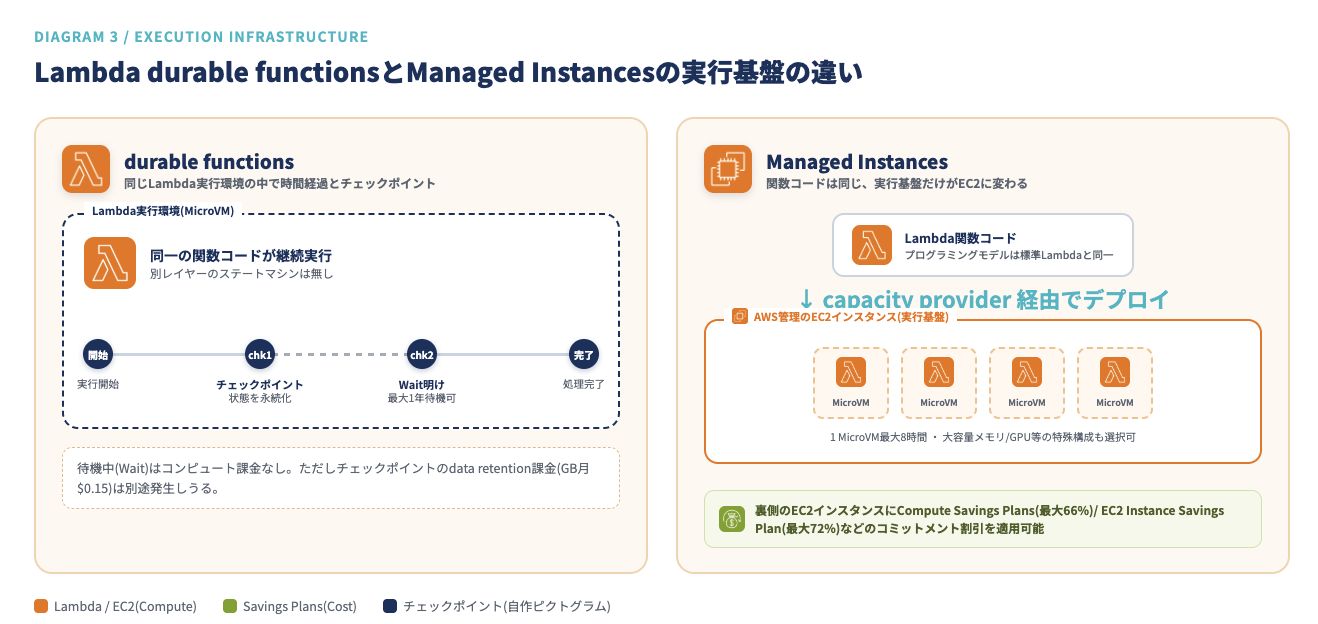
- 関数内で特定のステップを実行するたびに、その実行状態(入出力)を自動的にAWSの内部ステートストアにチェックポイントとして永続化する。
- 障害や再起動が起きても、直近のチェックポイントから処理を再開できる(Step Functionsで言う「ステートの永続化」を、コードの中に溶け込ませたイメージ)。
- 最大1年間、実行を一時停止(Wait)できる。Waitでは実行時間課金(コンピュート課金)は発生しないが、これは無条件に「無料で待てる」という意味ではない点に注意が必要だ。待機中もチェックポイントとして永続化されたデータのデータ保持課金(後述、GB月あたり0.15ドル)は別途発生しうるため、「待機=完全無課金」と誤解しないこと。
チェックポイントのペイロードサイズ上限について
チェックポイント1回あたりに保存できるデータは256KBまでというのが、AWS公式ドキュメントで明記されている仕様である。これは、AWS Lambda公式FAQ(aws.amazon.com/lambda/faqs/)の「Where is execution state stored and what are the size limits?」という項目に「Each checkpointed operation, such as a step or callback, can store up to 256 KB of data.」と明記されている。S3やDynamoDBなど、操作の中で読み書きする大きなデータ自体はこの上限にカウントされず、大きな結果を返す必要がある場合はカスタムシリアライザでS3等にオフロードし、チェックポイントには参照(キーなど)だけを渡す設計が公式に推奨されている。
加えて、AWS公式のサービスクォータページ(docs.aws.amazon.com/general/latest/gr/lambda-service.html)には、これとは別に「Durable execution storage written」というクォータが定義されており、1回のdurable execution全体を通じて永続化できる累積データ量は100MBまで(入出力ペイロード・チェックポイント・エラーデータの合計、リージョンごと、調整不可)となっている。整理すると次の2段階の上限がある。
| 上限の種類 | 数値 | 出典 |
|---|---|---|
| チェックポイント1回あたりのペイロードサイズ | 256KB | AWS Lambda FAQ(aws.amazon.com/lambda/faqs/) |
| durable execution全体の累積永続化データ量 | 100MB | AWS Lambda quota一覧(docs.aws.amazon.com/general/latest/gr/lambda-service.html) |
| 1つのdurable executionあたりのdurable operation数上限 | 3,000回 | 同上 |
料金の考え方と試算例
durable functionsの課金要素は、標準Lambdaの課金(リクエスト課金+コンピュート課金)に加えて、次の3つが上乗せされる。
- durable operations課金:ステップの開始・完了・コールバックなど、状態を永続化する操作ごとの課金。
- data written課金:durable operationsによって書き込まれるデータ量(GBあたり0.25ドル)。
- data retention課金:実行中および実行完了後の保持期間中にデータを保持することに対する課金(GB月あたり0.15ドル、保持期間はデフォルト14日・1〜90日で設定可能)。
この試算例として、AWS公式pricing page(aws.amazon.com/lambda/pricing/)に、保険金請求処理システムを想定した公式試算例が掲載されている。月100万件の保険金請求(1GBメモリ、ARMアーキテクチャ)を処理するケースで、内訳は以下の通り。
| 費用項目 | 金額 |
|---|---|
| コンピュート課金 | $421.34 |
| リクエスト課金 | $0.20 |
| durable operations課金 | $32.00 |
| data written課金 | $26.00 |
| data retention課金 | $10.92 |
| 合計 | $490.46 |
メリット
- Step Functionsのような別レイヤーのステートマシン定義が不要で、使い慣れたプログラミング言語(Python/Node.js)のコードの中に「チェックポイント」を書くだけで長時間ワークフローが組める。
- 最大1年間の待機(人の承認待ち、外部APIのポーリングなど)がコンピュート課金なしで実現できる。
- 既存のLambda関数の delivery pipeline(CI/CD、モニタリング)をほぼそのまま流用できる。
デメリット
- 2026年9月時点でGAから日が浅く、対応言語がPython/Node.jsに限定される(Java、Go等は非対応)。
- チェックポイントのペイロードサイズ上限(256KB)、累積データ量上限(100MB)、durable operation数上限(3,000回)など、Step Functionsとは異なる新しい制約を把握しておく必要がある。
- Step Functionsのような「コンソール上でのビジュアルなワークフロー可視化」は現時点では簡易的で、複雑な分岐が多いワークフローの可視性はStep Functionsに一日の長がある。
選ぶべき時
- 既存のLambda関数をベースに、長時間の待機や再開処理を「コードレベルで」追加したい場合。
- Python/Node.jsで完結する処理で、Step Functionsのステートマシン定義を新たに学習するコストを避けたい場合。
- AI/LLMエージェントのように、人間のフィードバック待ちや外部ツール呼び出しの完了待ちが断続的に発生するワークフロー。
選ぶべきでない時
- Java/Go/.NET等、Python/Node.js以外の言語で実装する必要がある場合。
- 1回の処理結果が256KBを超えるような大きなデータをチェックポイントのたびにやり取りする設計になっている場合(S3等への参照渡しへの設計変更が必要)。
- 複雑な分岐・並列処理を伴うワークフローで、Step Functionsのようなビジュアルな可視化・監査証跡を業務要件として求められる場合。
業務ユースケース例
- 保険金請求の自動審査(不正検知→高額請求は人間のレビュー待ち→承認後に支払い処理)。
- LLMエージェントによる複数ステップのタスク実行(ツール呼び出し→結果待ち→次のステップ判断)。
3-2. AWS Lambda Managed Instances(2025年11月GA)
2025年11月30日にGAした新しい実行環境。Lambdaのプログラミングモデル(関数を書いてデプロイするだけ)はそのままに、実行基盤を「Lambdaが内部管理するEC2インスタンス(MicroVM)」に変更できる仕組み。関数はcapacity provider経由でEC2インスタンス上のMicroVMにデプロイされ、1つのMicroVMの最大実行時間は8時間。
メリット
- Lambda標準では使えない特殊なコンピュート構成(より大きなvCPU/メモリ構成、GPUなど)へのアクセスが可能になる。
- 稼働率の高い定常的なワークロードでは、後述の割引の仕組みを組み合わせることでコストメリットが出るケースがある。
- Lambdaのデプロイ体験(関数コード+設定)を維持したまま、EC2の柔軟性を取り込める。
コストの考え方
AWS公式pricing pageに基づくと、割引側と追加コスト側の両方を押さえておく必要がある。
- 割引側:Managed Instancesの裏側で動くEC2インスタンスに対して、Compute Savings PlansやReserved InstancesといったEC2のコミットメント型割引をそのまま適用できる。AWS公式ページ(aws.amazon.com/savingsplans/compute-pricing/)によれば、インスタンスファミリー・リージョン等を問わず柔軟に適用できるCompute Savings Planはオンデマンド価格に対して最大66%の割引、インスタンスファミリーをリージョン単位で固定するかわりに割引率を高めたEC2 Instance Savings Planは最大72%の割引となっている。ただし、これは「Managed Instances固有の割引」ではなく、あくまで裏側のEC2インスタンスに対する一般的なEC2の割引プログラムを適用できるという話であり、割引を受けるには相応の期間のコミットメントが前提になる。
- 追加コスト側:Managed Instancesには、標準Lambdaと同様のリクエスト課金(100万リクエストあたり0.20ドル)に加えて、Lambdaが実行基盤の管理を代行することに対するマネジメント手数料(EC2オンデマンド価格に対して15%)が上乗せされる。この15%はコミットメント割引の有無にかかわらず、EC2オンデマンド価格を基準に計算される。
つまり実際のコスト構造は「EC2インスタンス実費 + EC2実費の15%相当のマネジメント手数料 + リクエスト課金($0.20/百万件)」であり、そこから任意でEC2側のコミットメント割引(Compute Savings Planで最大66%、EC2 Instance Savings Planで最大72%)を組み合わせられる、というのが正確な理解になる。コミットメントなしの素のオンデマンド利用では、標準Lambdaの方が低〜中トラフィック域では有利になりやすく、コミットメント型の割引を組み合わせて初めて、高稼働・大量呼び出しのワークロードでコストメリットが出てくる、という設計として捉えるのが実態に近い。なお、具体的に何リクエスト/月からコストメリットが逆転するかという損益分岐点については、AWS公式ページ上に明記された基準値は確認できなかった。これは利用するインスタンスタイプ、稼働率、コミット期間・支払い方法などワークロードの前提によって大きく変動するため、本稿では具体的な数値を断定しない。実際の採用判断にあたっては、AWS Pricing Calculator等を用いて自社のトラフィックパターンに基づく個別試算を行うことを推奨する。
デメリット
- コストメリットを最大化するには長期(3年)のコミットメントが前提になり、トラフィックが不確実な新規サービスには向かない。
- リクエスト課金とマネジメント手数料が別途発生するため、割引率だけを見て「安くなる」と判断すると想定外のコストになりうる。
- EC2インスタンスという「裏側のインフラ」が見える分、Lambda標準よりは運用上意識すべき対象が増える(インスタンスタイプの選定、容量計画など)。
選ぶべき時
- 稼働率が高く恒常的なワークロードで、EC2のコミットメント型割引(Savings Plans/Reserved Instances)を活用したコスト最適化が見込める場合。
- Lambda標準の実行環境では得られない特殊なコンピュートリソース(大容量メモリ、GPU等)が必要な場合。
- 月間の呼び出し量が非常に大きく、3年コミットを前提にしたコスト試算でLambda標準を上回るメリットが確認できた場合。
選ぶべきでない時
- トラフィックが不確実、あるいは低〜中トラフィックのワークロード(素のLambda標準の方が安価になりやすい)。
- 長期コミットメントを組みたくない、あるいは組めない事業フェーズ(検証段階のサービスなど)。
- 運用がシンプルであることを最優先したい場合(EC2インスタンス層の考慮が増える分、認知負荷は上がる)。
業務ユースケース例
- 恒常的に高負荷が続く画像・動画のバッチ変換処理基盤(GPU等の特殊インスタンスを利用)。
- 月間数千万〜億単位のリクエストを処理する社内基盤系API(3年のSavings Planを前提にコスト試算した上で移行)。
第4章 判断基準の早見表
4つの選択肢を、実務でよく問われる10の観点で横並びに整理した。表を読む前に、次の3点を押さえておくと大枠の判断がつきやすい。
- 「まず何を優先するか」で列を絞り込むのが実務的だ。可視化・監査ログを最優先するならStep Functions、実行時間15分の壁が最大の課題ならdurable functionsかStep Functions、コストを最優先するがコミットメントも辞さないならManaged Instances、とにかくシンプルに早く作りたいならLambda標準、という優先順位の立て方がわかりやすい。
- durable functionsとStep Functionsは「どちらも長時間ワークフローに対応する」という点で競合するが、Step Functionsは複数言語・複数サービスにまたがる複雑な分岐を可視化したい場合に強く、durable functionsは単一言語(Python/Node.js)でコードベースの実装に寄せたい場合に強い、という住み分けで捉えると判断しやすい。
- Managed InstancesはLambda標準の「置き換え」ではなく、Lambda標準で足りない特殊なコンピュートリソースが必要、または3年コミット前提でコストメリットが出るほどの規模がある場合の追加の選択肢と位置づけるのが実態に近い。低〜中規模のワークロードでは、素のLambda標準の方が総コストが低いケースの方が多い。
| 観点 | Lambda標準 | Step Functions | Lambda durable functions | Managed Instances |
|---|---|---|---|---|
| 実行時間の上限 | 900秒(15分) | Standardは最大1年、Expressは最大5分 | 最大1年(Waitによる一時停止を含む) | MicroVM単位で最大8時間 |
| 状態管理・再開の仕組み | 自前実装が必要(DB/SQS等を併用) | ステートマシン定義で標準サポート | コード内のチェックポイントで標準サポート | Lambda標準に準じ、自前実装が必要 |
| 対応言語 | 主要言語全般 | 言語非依存(ASLでオーケストレーション、各ステップは任意言語) | Python(3.13/3.14)、Node.js(22/24)のみ | 主要言語全般(Lambda標準に準ずる) |
| 可視化・監査ログ | なし(自前でCloudWatch Logs等) | コンソールでステップ単位に標準可視化、Standardは90日履歴保持 | 実行履歴の参照は可能だが、Step Functions級のビジュアル可視化は簡易的 | なし(Lambda標準に準ずる) |
| 主な課金要素 | リクエスト数+GB秒 | Standard: state transition数、Express: リクエスト数+実行時間 | リクエスト数+GB秒+durable operations+data written+data retention | リクエスト数($0.20/百万件)+EC2実費+管理手数料15% |
| 待機中の課金 | 該当なし(即時実行が前提) | Standardはstate transition課金のみで待機自体は無課金 | コンピュート課金は発生しないが、data retention課金(GB月$0.15)は別途発生しうる | 該当なし(Lambda標準に準ずる) |
| コスト最適化の前提 | 特になし(従量課金のみ) | 特になし(従量課金のみ) | 特になし(従量課金のみ) | 3年コミットのCompute Savings Plans等を組んで初めて割引効果が出る |
| 学習コスト | 低い(既存の関数開発の延長) | 中〜高い(ASLの学習が必要) | 中程度(既存コードにチェックポイントを追加する発想) | 低い(Lambda標準の延長だが、EC2層の知識も必要) |
| GA時期・成熟度 | 長年運用実績あり(最も成熟) | 長年運用実績あり(成熟) | 2025年12月GA(日が浅い) | 2025年11月GA(日が浅い) |
| 向いているワークロードの性格 | 単発・短時間のイベント処理 | 複数ステップ・複数サービスの可視化が必要な業務フロー | 長時間待機を伴う、コードベースでの状態管理 | 高稼働率・大規模・コミット前提の定常ワークロード |
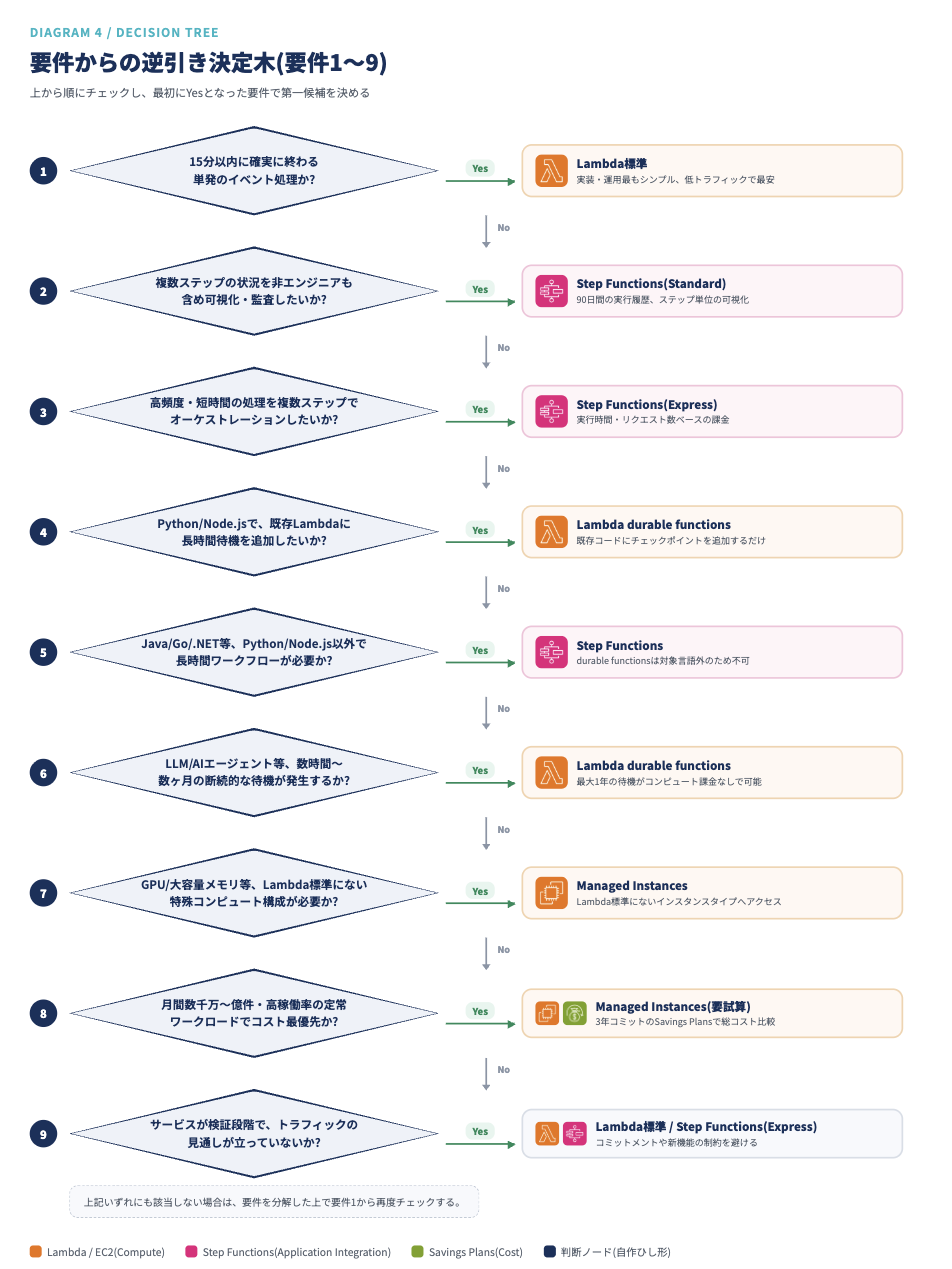
第5章 システム要件からの逆引き
「うちのシステムはこういう要件がある、ではどれを選ぶべきか」という逆引きの形で整理する。複数の要件が絡む場合は、上から順にチェックし、最初に該当した選択肢を第一候補とするのが実務的なアプローチだ。
要件1:処理が15分以内に確実に終わる単発のイベント処理である
→ Lambda標準を第一候補にする。複数ステップの状態管理やワークフローの可視化が不要なら、他の3つの選択肢を検討する必要はない。実装・運用ともに最もシンプルで、コストも低トラフィック帯で最も有利。
要件2:複数ステップにまたがる処理で、各ステップの実行状況を非エンジニア(業務部門など)も含めて可視化・監査したい
→ Step Functions(Standardワークフロー)を第一候補にする。コンソール上でステップごとの成功・失敗が視覚的に確認でき、90日間の実行履歴が標準で保持される。与信審査や経費精算など、業務監査の要件が明示的にある場合はStep Functionsが最も適合する。
要件3:高頻度・短時間(数秒〜数分)のイベント処理を、複数ステップでオーケストレーションしたい
→ Step Functions(Expressワークフロー)を検討する。Standardのstate transition課金は高頻度実行だとコストが積み上がりやすいため、実行時間・リクエスト数ベースの課金体系であるExpressの方が適合しやすい。ただし実行履歴が自前でのCloudWatch Logs管理になる点は要考慮。
要件4:Python/Node.jsで実装しており、既存のLambda関数のコードベースを維持したまま、長時間の待機(人の承認待ち、外部処理の完了待ちなど)を追加したい
→ Lambda durable functionsを第一候補にする。ステートマシン定義という別レイヤーを新たに学ぶ必要がなく、既存のコードに近い形でチェックポイントを挿入するだけで長時間ワークフロー化できる。ただし1回のチェックポイントで256KBを超えるデータをやり取りする設計になっている場合は、S3等への参照渡しへの設計変更が先に必要になる。
要件5:Java/Go/.NET等、Python/Node.js以外の言語で長時間ワークフローを実装する必要がある
→ Step Functionsを選ぶ。durable functionsは2026年9月時点でPython/Node.jsにしか対応しておらず、それ以外の言語では選択肢に入らない。
要件6:LLM/AIエージェントのように、外部ツール呼び出しやユーザーからのフィードバック待ちが断続的に発生し、待機時間が数時間〜数ヶ月単位になりうる
→ Lambda durable functionsを第一候補にする。最大1年間の待機がコンピュート課金なしで実現できる点がこのユースケースに強く適合する。ただし待機中もdata retention課金(GB月$0.15)は発生しうるため、長期間・大量のセッションを同時に待機させる設計の場合は、このコストも試算に含めること。複雑な分岐が多い場合はStep Functionsとの併用(Step Functionsで大枠のフローを制御し、各ステップの中でdurable functionsのような待機処理を行う)も選択肢になる。
要件7:GPUや特殊なコンピュート構成(大容量メモリ等)がLambda標準の制約上使えない
→ Managed Instancesを検討する。Lambda標準の実行環境では提供されないインスタンスタイプへのアクセスが可能になる。ただしこの要件だけでは3年コミットを組む必然性はないため、まずはオンデマンドで小さく検証し、稼働率の見通しが立ってからコミットメント割引を検討する順序が安全。
要件8:月間の呼び出し数が非常に大きく(数千万〜億単位)、稼働率が高く安定している定常ワークロードで、コストを最優先で最適化したい
→ Managed Instancesを第一候補として、3年コミットのCompute Savings Plansを組んだ場合の総コスト(EC2実費×コミット割引後の単価+管理手数料15%+リクエスト課金$0.20/百万件)と、Lambda標準の総コスト(リクエスト課金+GB秒課金)を必ず両方試算して比較すること。稼働率が低い、あるいはトラフィックの見通しが不確実な場合は、コミットメントのリスクの方が大きくなるため、要件1のLambda標準に戻ることも十分にありうる判断。
要件9:サービスがまだ検証段階で、トラフィックの見通しが立っていない
→ Lambda標準、複数ステップが必要ならStep Functions(Express)を選ぶ。Managed Instancesのコミットメント割引はトラフィックが読めない段階では活かしようがなく、durable functionsも新しい制約(256KB/100MBの上限、対応言語の制約)を把握するコストが検証段階では見合わないことが多い。
第6章 まとめ — 「増えた選択肢」は「複雑になった」ではなく「精度が上がった」
選択肢が増えたことそのものよりも重要なのは、「どれか1つが正解」という発想のまま4つの選択肢を眺めないことだと思う。実際には、Lambda標準・Step Functions・durable functions・Managed Instancesは互いに排他的な選択肢ではなく、同じシステムの中で組み合わせて使うのが前提になっている。
- 単発のイベント処理はLambda標準のまま。
- 複数ステップの可視化・監査が必要な業務フローはStep Functions。
- 既存のLambda関数に長時間待機を足したいだけならdurable functions。
- 稼働率が高く、コミットメント割引が活きる規模の処理だけをManaged Instancesに寄せる。
このように役割分担させることで、「なんでもLambda標準に詰め込んで15分の壁にぶつかる」「なんでもStep Functionsのステートマシンにして学習コストが跳ね上がる」といった、これまでの二択時代にありがちだった歪みを減らせる。
一方で、durable functionsとManaged Instancesはどちらも2025年後半にGAしたばかりの機能であり、対応言語やコミットメントの前提など、Step Functionsやそれ以前のLambda標準にはなかった新しい制約がある。本稿執筆時点(2026年9月)でも情報のアップデートが続く領域なので、実際の採用判断にあたっては、必ずAWS公式ドキュメント・pricing pageの最新版を確認してから設計に落とし込んでほしい。
参考文献
- ServerlessDays Tokyo 2026 公式サイト
- AWS Lambda – FAQs
- AWS Lambda endpoints and quotas
- AWS Lambda Pricing
- AWS Lambda announces durable functions for multi-step applications and AI workflows
- AWS Lambda durable functions are now available in 14 additional AWS Regions
- Announcing AWS Lambda Managed Instances
- AWS Step Functions Pricing
- Configure Lambda function timeout
- AWS Fargate — Serverless Compute Engine
AWS・エンジニアリングマネジメントの実務ネタを発信しています
コメント