はじめに
ServerlessDays Tokyo 2026に参加した際、TiDBというキーワードが気になった。
この記事では、AWS認定資格の学習やEM(エンジニアリングマネージャー)としての技術選定の場面で「NewSQLって結局何なのか」「TiDBとAurora DSQLは同じカテゴリの製品なのか」「NoSQL(DynamoDB/Keyspaces)との違いは何か」を整理する。技術記事としての性質上、筆者が実際に検証・確認できた範囲の情報のみを記載し、未検証の性能数値や体験は書かない方針とする。
第1章 NewSQLとは何か
1.1 定義
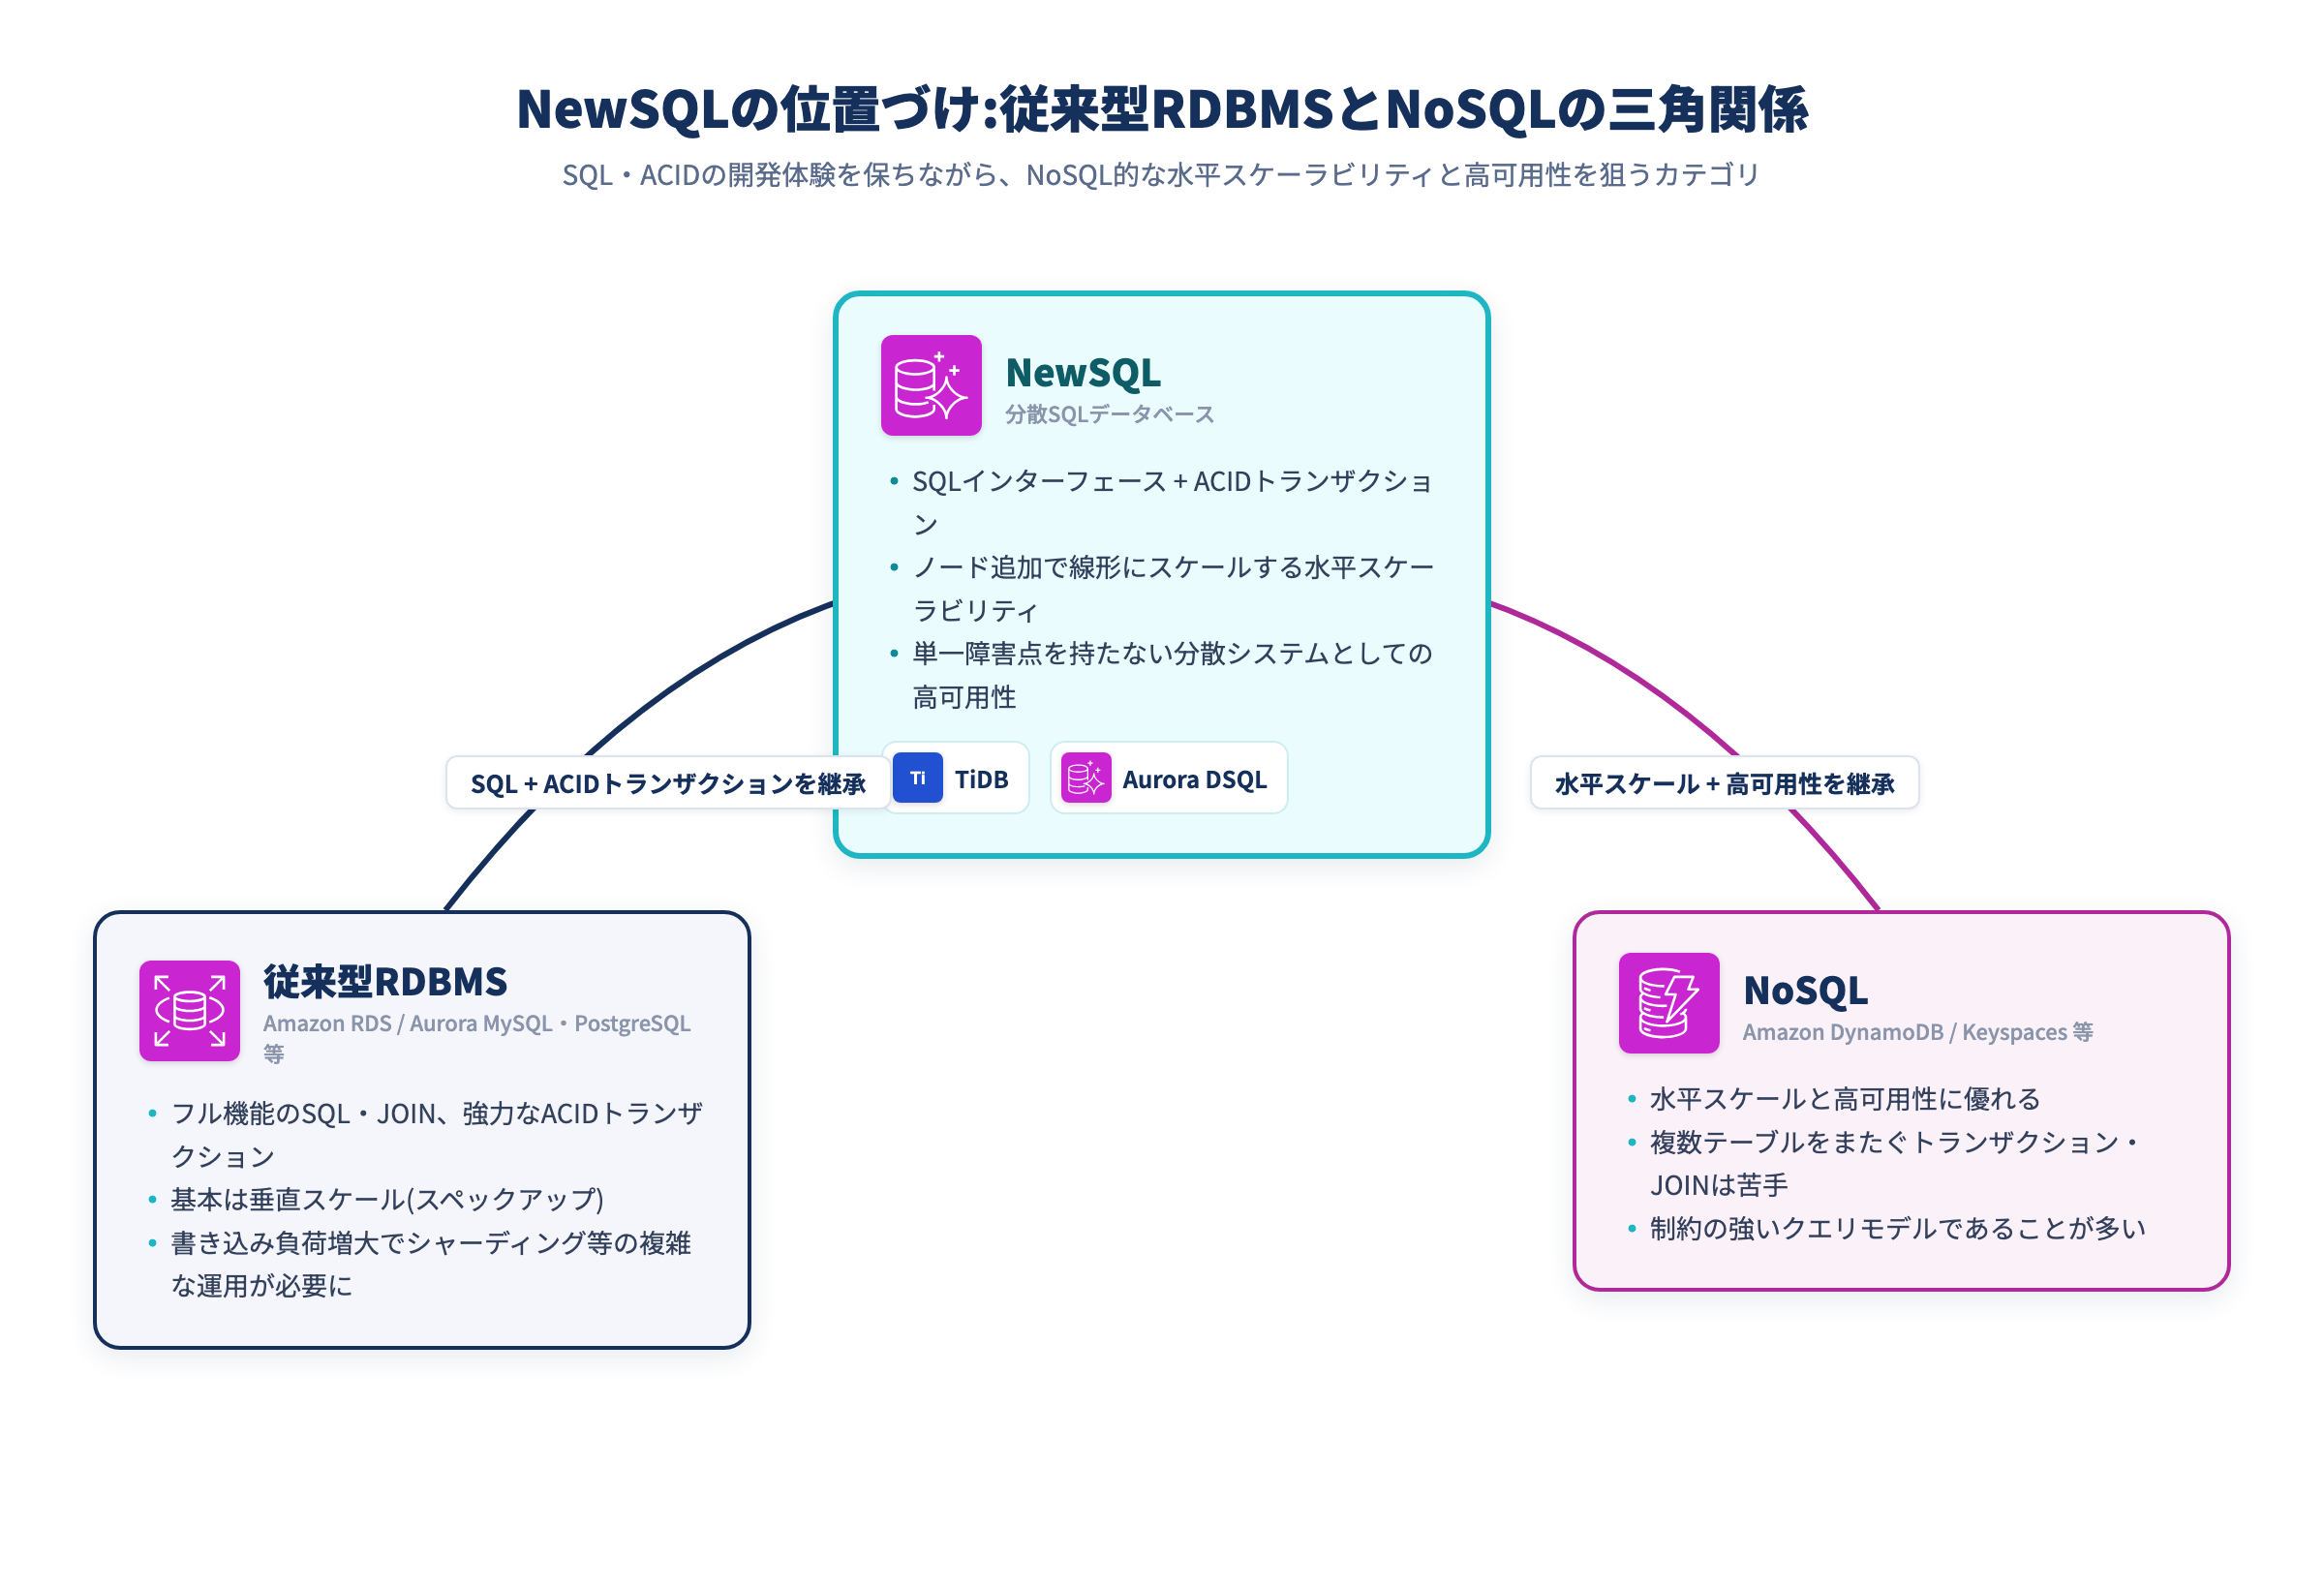
NewSQLとは、次の3つの性質を同時に満たすことを目指すデータベースのカテゴリを指す用語である。
- SQLインターフェースとACIDトランザクションを提供する(従来型RDBMSと同じ開発体験)
- 水平スケーラビリティを持つ(NoSQLのようにノードを追加してスループットを線形に拡張できる)
- 分散システムとして高可用性を実現する(単一障害点を持たない、または最小化する)
用語自体は2011年にアナリストのMatthew Aslettが、Google SpannerやVoltDBのような新世代の分散データベースを指して提唱したのが始まりとされる。以来、Google Cloud Spanner、CockroachDB、YugabyteDB、TiDB、そして本稿で扱うAmazon Aurora DSQLなど、複数の実装が登場している。
1.2 なぜ生まれたか
従来型RDBMS(MySQL、PostgreSQLなど)は単一ノードでの垂直スケール(スペックアップ)が基本であり、書き込み負荷が増えるとシャーディングなど複雑な運用が必要になる。一方でNoSQL(DynamoDBなど)は水平スケールと高可用性に優れるが、複数テーブルをまたぐトランザクションやJOINを伴う複雑なクエリが苦手、あるいは制約が強い。
NewSQLは「RDBMSの開発体験を保ったまま、NoSQL的なスケーラビリティを得る」という、両者のいいとこ取りを狙うカテゴリとして位置づけられる。裏側では、Paxos/Raftなどのコンセンサスアルゴリズムでデータをレプリケーションしつつ、分散トランザクション(2相コミットや、タイムスタンプベースの順序保証など)によってACID特性を担保する実装が多い。
1.3 NewSQLは万能ではない
一方で、分散合意やクロスシャードトランザクションのコストはゼロにはならない。単一ノードRDBMSに比べてレイテンシが増える場面、特定の書き込みパターン(後述するホットスポット問題など)に弱い場面もある。「なんでもNewSQLにすればいい」という単純な話ではなく、要件次第では従来型RDBMSやNoSQLの方が適切な場合も多い、という前提を持って読み進めてほしい。
第2章 TiDBとは何か
2.1 概要
TiDBは中国のPingCAP社が開発し、Apache License 2.0で公開しているオープンソースの分散SQLデータベースである。マネージドサービス版として「TiDB Cloud」も提供されている。
2.2 アーキテクチャ
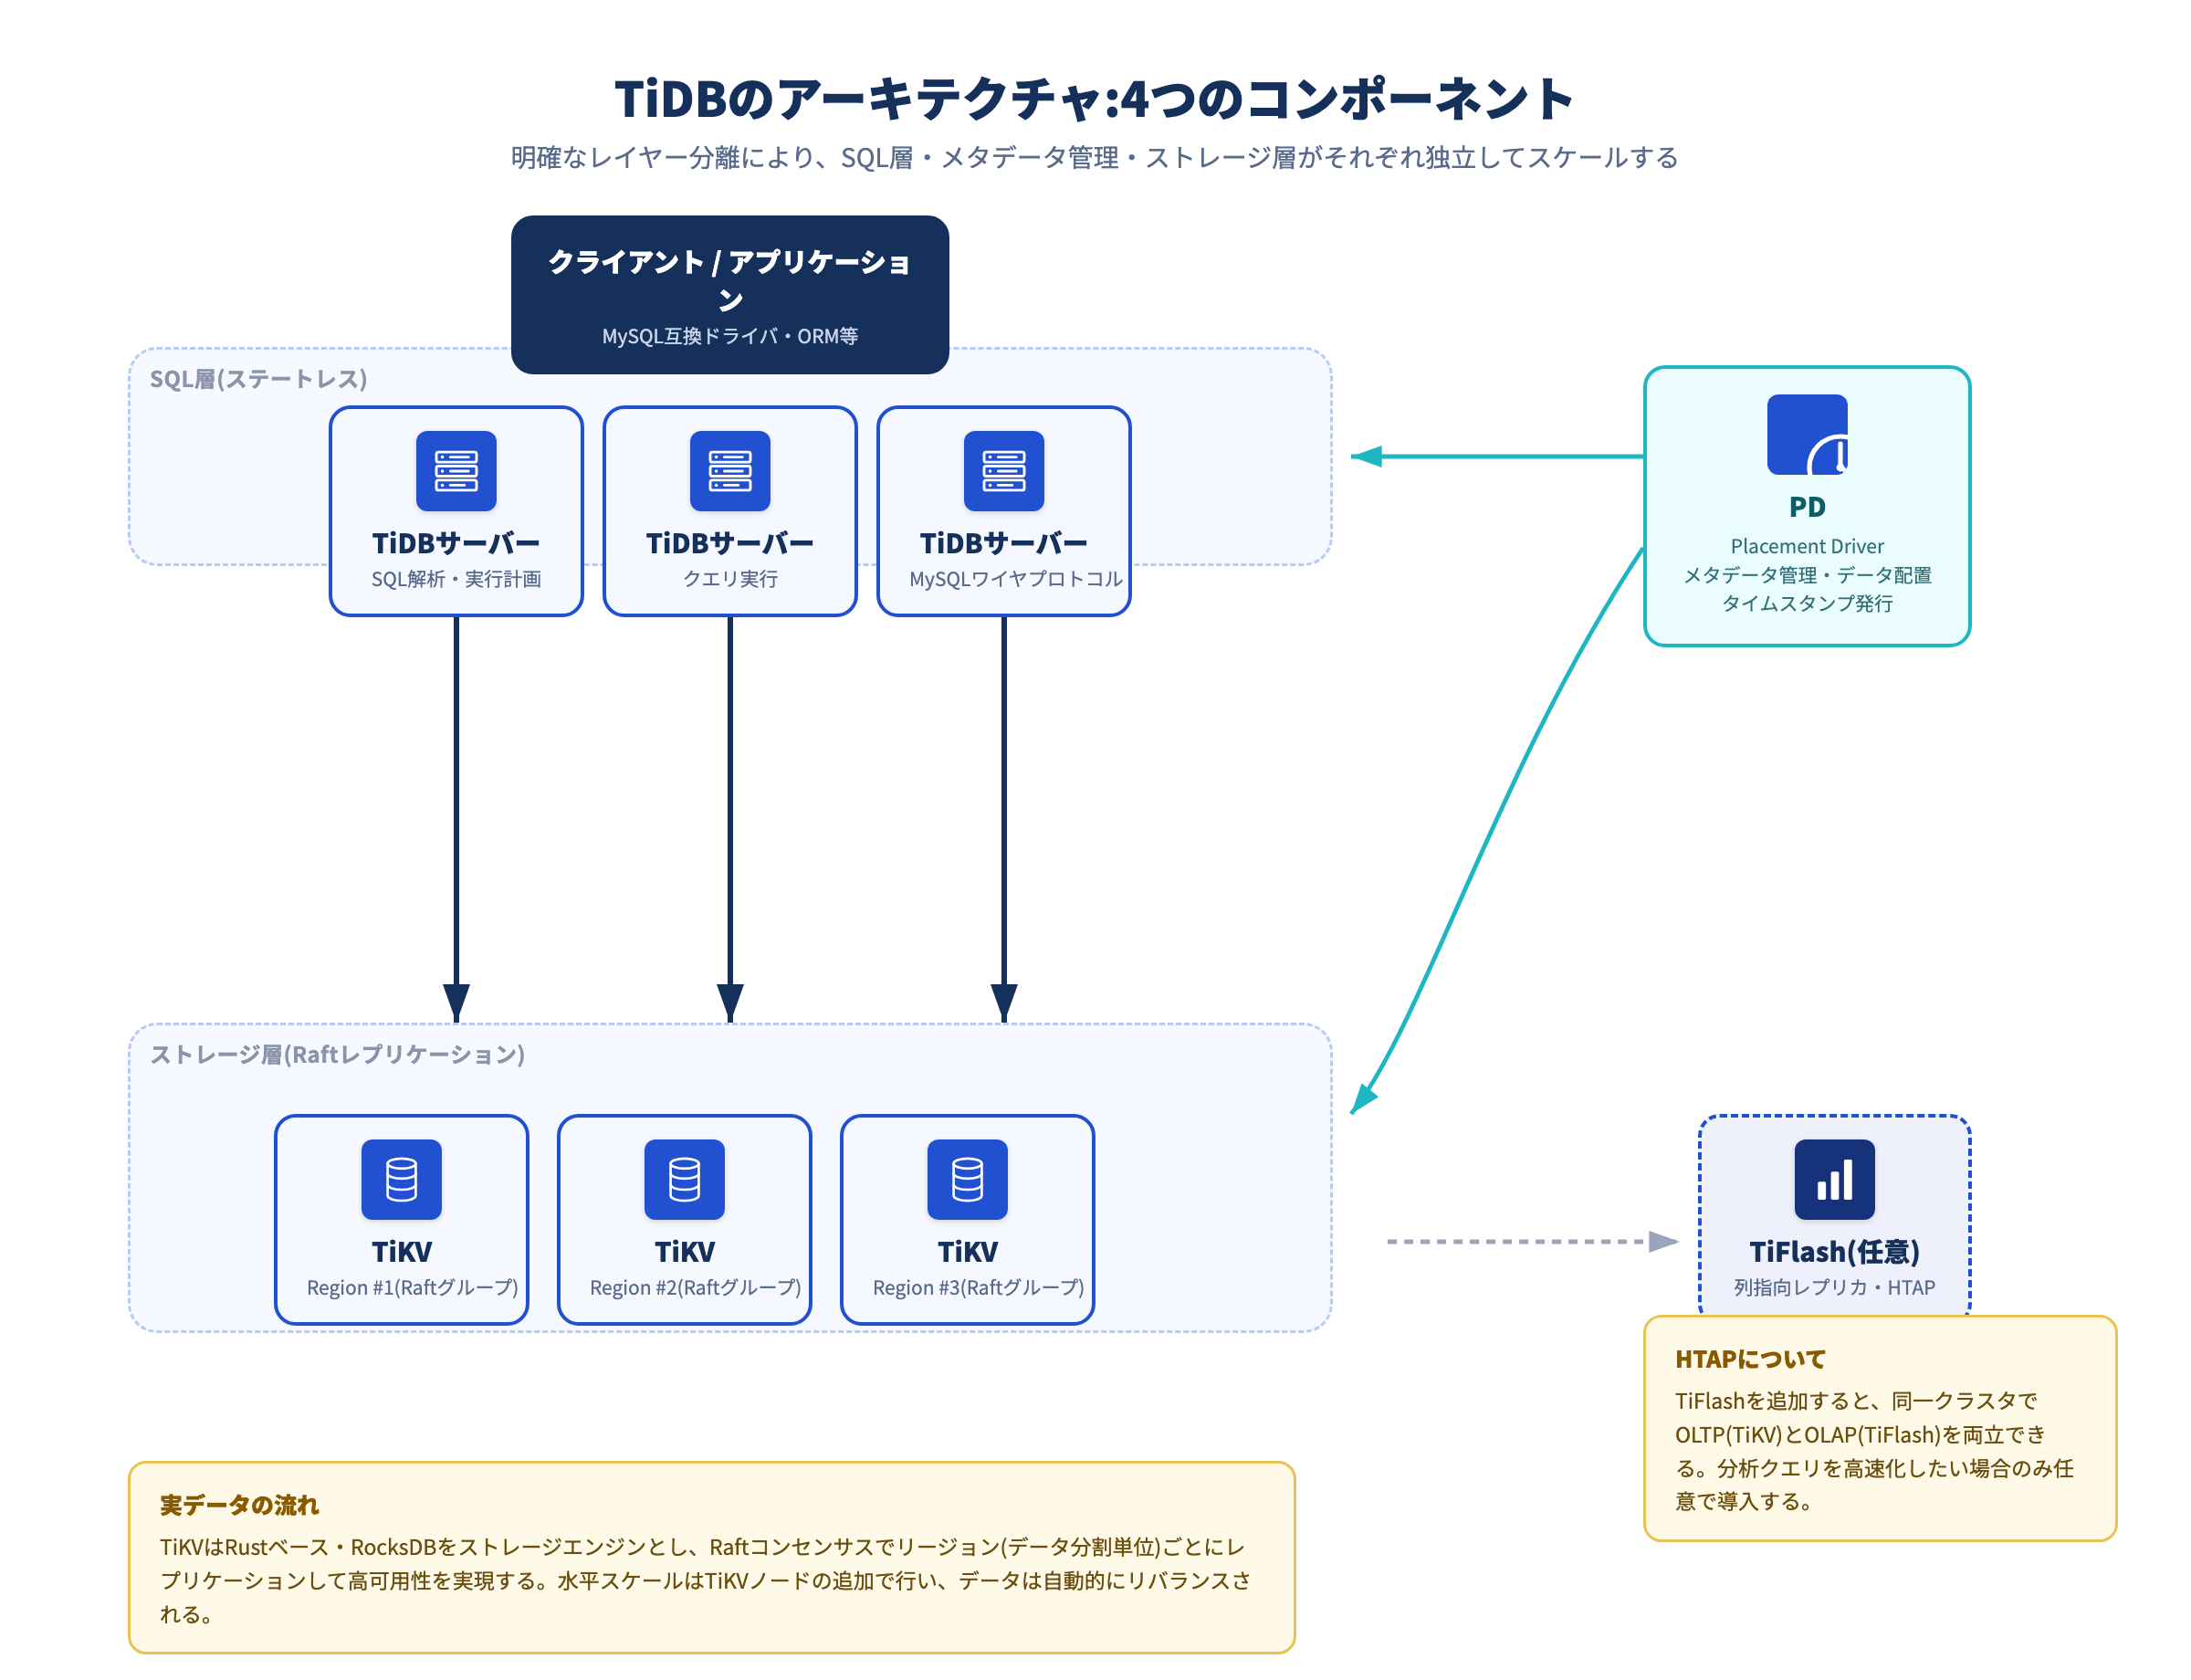
TiDBは役割の異なる複数のコンポーネントで構成される、明確なレイヤー分離を特徴とする。
- TiDBサーバー: SQLの解析・実行計画の生成・クエリ実行を担当するステートレスな層。MySQLワイヤプロトコル互換(5.7/8.0系の構文・機能に対応)であり、MySQL用のドライバやツール(mysqlクライアント、各種ORM等)がほぼそのまま使える。
- PD(Placement Driver): クラスタ全体のメタデータ管理、データ配置、タイムスタンプ発行(グローバルなトランザクション順序保証)を担当する。
- TiKV: 実データを保持する分散KVストア。Raftコンセンサスアルゴリズムでリージョン(データの分割単位)ごとにレプリケーションし、高可用性を実現する。RustベースでRocksDBをストレージエンジンとして利用する。
- TiFlash(任意): 列指向ストレージのレプリカを追加し、OLAP(分析)クエリを高速化するHTAP(Hybrid Transactional/Analytical Processing)コンポーネント。同一クラスタでOLTPとOLAPを両立させたい場合に利用する。
2.3 特徴として押さえておくべき点
- MySQLワイヤプロトコル互換のため、既存のMySQLアプリケーションからの移行障壁が比較的低い。
- 水平スケールはTiKVノードの追加で行い、データは自動的にリバランスされる。
- 自前でクラスタを構築・運用する場合はTiKV/PD/TiDBサーバー/(TiFlash)という複数コンポーネントの運用知識が必要になる。マネージド版のTiDB Cloudを使えばこの運用負荷は大幅に軽減される。
第3章 AWSの相当サービスを検証する ― Amazon Aurora DSQL
3.1 概要
Amazon Aurora DSQLは、2024年12月のre:Inventで発表され、2025年に一般提供(GA)が開始された、AWSのサーバーレス分散SQLデータベースである。PostgreSQL互換のワイヤプロトコルを採用しており、既存のPostgreSQLドライバやORMが概ねそのまま利用できる。
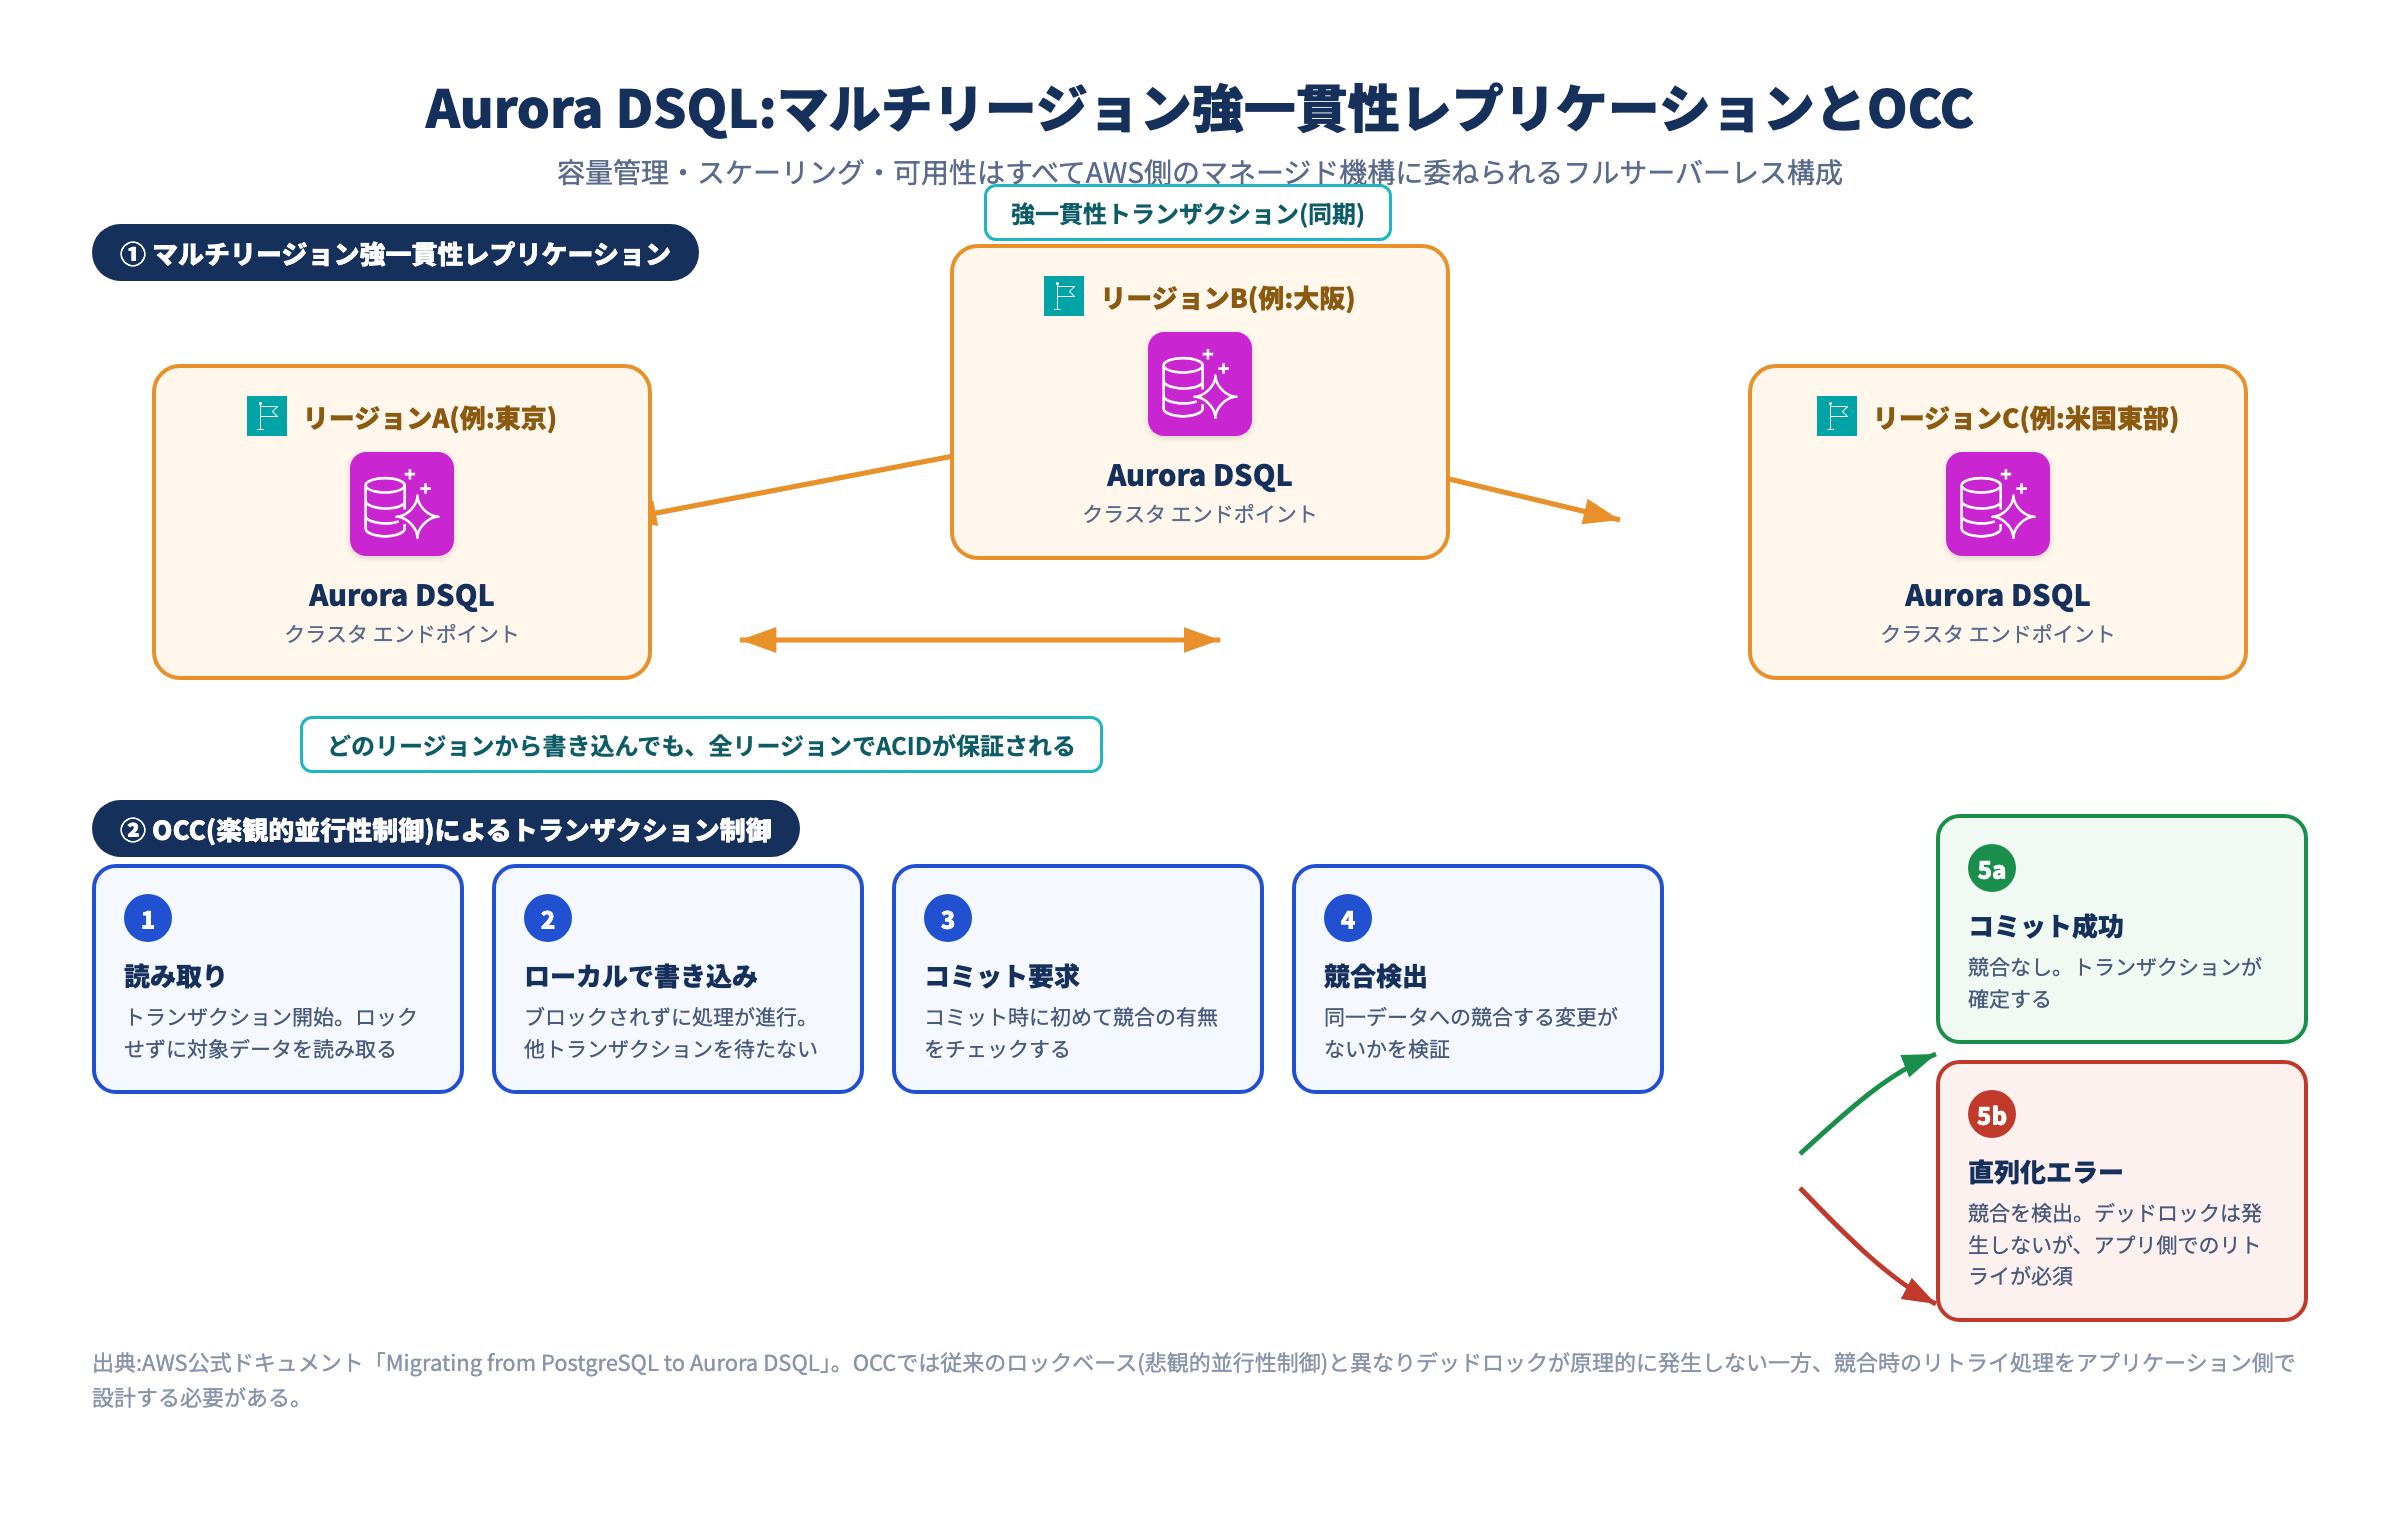
Aurora DSQLの最大の特徴は、TiDBのようにユーザーがTiKVやPDに相当するコンポーネントを意識・運用する必要がない、フルサーバーレスの分散SQLデータベースである点にある。容量管理・ストレージのスケーリング・可用性の担保はすべてAWS側のマネージド機構に委ねられる。マルチリージョン構成を選ぶと、複数リージョンにまたがる強一貫性のトランザクションも提供される。
トランザクションの同時実行制御にはOCC(楽観的並行性制御)が採用されている。従来型のロックベース(悲観的並行性制御)とは異なり、トランザクションはブロックされずに進行し、コミット時に競合が検出されると直列化エラー(シリアライゼーションエラー)が返される。これによりデッドロックが原理的に発生しない一方、アプリケーション側でリトライ処理を実装する設計が必須になる(出典: AWS公式ドキュメント「Migrating from PostgreSQL to Aurora DSQL」)。
3.2 PostgreSQLとの機能差分
Aurora DSQLは「PostgreSQL互換」を謳っているが、分散アーキテクチャとサーバーレス運用を実現するために、いくつかの機能が意図的にサポート対象外、または代替パターンへの置き換えが推奨されている。2026年9月時点でAWS公式ドキュメントが明示している主な制約は以下の通りである。
未対応・非推奨(代替パターンへの移行が必要)
- トリガー(トリガー相当の処理はアプリケーション層またはEventBridge等のイベント駆動アーキテクチャで代替することが推奨されている)
- ストアドプロシージャ(PL/pgSQLなどの手続き型言語)。SQL関数は利用可能。複雑なロジックはアプリケーション層やAWS Lambdaへの移行が推奨される
- ほとんどのPostgreSQL拡張機能(PostGIS、pgvector、pgcryptoなど。ストレージエンジンの違いに起因する)
- 一時テーブル(CTEやサブクエリ、通常テーブル+クリーンアップ処理での代替が推奨される)
TRUNCATE(DELETE FROMまたはDROP TABLE→CREATE TABLEでの代替が推奨される)- 1クラスタにつきデータベースは
postgresという名前の1つのみ(論理分離が必要な場合はスキーマ、またはクラスタ自体を分ける)
過去に制約とされていたが、現在は対応済みの機能
シーケンス・IDENTITY列については、以下の通り対応済みである。
Amazon Aurora DSQLは、2026年2月13日付のAWS公式アップデートで、シーケンスオブジェクトおよびIDENTITY列(自動採番のPostgreSQL互換の整数ID)に対応した。これにより、オーダー番号やアカウントIDのような人間可読な連番IDを、アプリケーション側で採番ロジックを持たずにデータベース側で生成できるようになっている。分散環境向けに、シーケンスは分散協調プリミティブとして実装されており、対応リージョンはAurora DSQLが利用可能な全リージョンとされている。
出典: Amazon Aurora DSQL adds support for identity columns and sequence objects(AWS What’s New, 2026年2月13日)
つまり本稿執筆時点(2026年9月)から遡ること半年以上前にすでに解決済みの制約である。
同様に、外部キー制約についても、AWS公式の移行ガイドでは「Aurora DSQLは外部キー、テーブル間のリレーション、JOIN操作をサポートしている」と明記されている(出典: AWS公式ドキュメント「Migrating from PostgreSQL to Aurora DSQL」)。かつては未対応とされていた時期もあったが、現在は対応済みである。
トランザクションに関するその他の制約(2026年9月時点)
- DDLとDMLは別トランザクションで実行する必要がある
- 1トランザクションに含められるDDL文は1つまで
- 1トランザクションで変更できる行数は最大3,000行(セカンダリインデックスの数によらない)
- データベース接続は1時間でタイムアウトする
- トランザクション分離レベルはPostgreSQLの
Repeatable Readに固定
これらは機能追加によって将来変わりうる制約のため、大規模なシステムを設計する際は必ず最新のAWS公式ドキュメント「Considerations for working with Amazon Aurora DSQL」を確認してほしい。
3.3 リージョン展開について(時点情報の注記)
Aurora DSQLは2025年のGA以降、対応リージョンを継続的に拡大している。2026年2月・5月・7月にも追加リージョンや追加のマルチリージョン対応が発表されている。筆者が2026年9月時点で確認できた範囲では、単一リージョン構成でおおよそ19リージョン程度(バージニア北部、オハイオ、オレゴン、カナダ中部/カルガリー、東京、大阪、ソウル、シンガポール、香港、メルボルン、シドニー、ムンバイ、アイルランド、ロンドン、フランクフルト、パリ、ストックホルム、サンパウロ等)が対応しているとみられる。
この数値は執筆時点の概算であり、AWSはリージョンを頻繁に追加するため、意思決定の際は必ずAWS公式のRegion availabilityページで最新情報を確認すること。 本記事の数値をそのまま提案書等に転記しないでほしい。
第4章 選ぶべき時・選ぶべきでない時
4.1 NewSQL(TiDB/Aurora DSQL)を選ぶべき時
- 書き込み・読み取りともに、単一ノードRDBMSのキャパシティを将来的に超える見込みがあり、かつシャーディングを自前実装したくない
- SQLでのJOINやトランザクション整合性を維持したまま、水平スケールしたい(NoSQLへの移行でアプリケーションロジックを大きく作り替えたくない)
- マルチリージョンでの強一貫性(グローバルにACIDトランザクションを維持したい)が要件にある
- 運用チームの人員が限られており、マネージドサービス(TiDB CloudまたはAurora DSQL)でインフラ運用負荷を下げたい
4.2 選ぶべきでない時
- トラフィック規模が小さく、単一ノードのAurora MySQL/PostgreSQLやRDSで十分にさばける(NewSQLの分散オーバーヘッドが不要なコストになる)
- トリガー・ストアドプロシージャ・PostGISのような拡張機能に強く依存したレガシーアプリケーションで、短期間での移行が求められている(前章の制約に抵触する可能性が高い)
- 1トランザクションで数千〜数万行を一括更新するバッチ処理が中核要件(Aurora DSQLの3,000行/トランザクション制約に抵触する。TiDBは行数上限の性質が異なるため個別に確認が必要)
- 秒未満の超低レイテンシ(1桁ミリ秒)が絶対要件で、かつアクセスパターンがシンプルなキー値取得中心(DynamoDBのようなNoSQLの方が適している可能性が高い)
第5章 メリット・デメリット比較
5.1 データベースカテゴリ横断の比較
| 観点 | 従来型RDBMS(Aurora MySQL/PostgreSQL等) | NewSQL(TiDB/Aurora DSQL) | NoSQL(DynamoDB/Keyspaces) |
|---|---|---|---|
| SQL/JOIN | ◎ フル機能のSQL | ○ 概ね標準SQLだが一部制約あり | △〜× 基本的に非対応、または限定的 |
| ACIDトランザクション | ◎ 単一ノード内で強力 | ○ 分散環境でも提供(OCC等で実現) | △ 製品によって限定的(単一パーティション内のみ等) |
| 水平スケーラビリティ(書き込み) | × 基本は垂直スケール、シャーディングは自前実装 | ◎ ノード追加で線形にスケール | ◎ パーティション追加で線形にスケール |
| マルチリージョン強一貫性 | × 基本的に非対応(Global Database等はリードレプリカ中心) | ○ 対応(Aurora DSQLのマルチリージョンクラスタ等) | △ 製品による(結果整合性が基本、一部で強一貫性オプションあり) |
| 運用の複雑さ(セルフホスト時) | ○ 実績豊富でノウハウが多い | △〜× 分散システムの知識が必要(マネージド利用で軽減) | ○ マネージド前提の製品が多く比較的容易 |
| 既存資産からの移行容易性 | ◎ そのもの | ○ ワイヤプロトコル互換で比較的容易 | × アプリケーションロジックの作り直しが必要な場合が多い |
| レイテンシ特性 | ◎ 低い(単一ノード) | △ 分散合意のオーバーヘッドがある | ◎ 低い(キー値アクセス中心) |
| 代表的な弱点 | スケール限界、単一障害点 | ホットスポット、機能制約(後述) | 複雑なクエリ・トランザクションが苦手 |
5.2 TiDBとAurora DSQLの比較
| 観点 | TiDB(セルフホスト/TiDB Cloud) | Amazon Aurora DSQL |
|---|---|---|
| プロトコル互換 | MySQLワイヤプロトコル互換(5.7/8.0系の構文・機能に対応) | PostgreSQLワイヤプロトコル互換 |
| アーキテクチャの可視性 | TiDBサーバー/PD/TiKV/TiFlashをユーザーが意識(セルフホスト時) | 完全サーバーレス。内部コンポーネントは非公開・非管理対象 |
| HTAP(分析クエリ対応) | TiFlash追加で対応可能 | 非対応(OLTP用途に特化) |
| 同時実行制御方式 | Percolatorモデルをベースにした分散トランザクション | 楽観的並行性制御(OCC)。競合時は直列化エラーを返しアプリ側でリトライ |
| ストアドプロシージャ/トリガー | 一部制限はあるがMySQL互換機能を志向 | 非対応(2026年9月時点。アプリ層/Lambda/EventBridgeでの代替が公式に推奨) |
| 拡張機能 | MySQLプラグインエコシステムに準拠 | PostGIS/pgvector等ほとんどの拡張機能が非対応 |
| デプロイ形態 | セルフホスト、マネージド(TiDB Cloud)、マルチクラウド展開が可能 | AWSのフルマネージドのみ(AWS外への展開不可) |
| 運用の主体 | セルフホストなら自社、TiDB Cloudなら委託 | 完全にAWS委託(容量計画・パッチ適用等が不要) |
| 主な弱点 | 大規模クラスタ運用にはRaft/分散KVの知識が必要(PingCAP公式ドキュメント) | 前述の機能制約、1トランザクション3,000行制約(AWS公式ドキュメント) |
第6章 ユーザー視点の業務ユースケース
抽象的な機能比較だけでは選定判断がしづらいため、実際の業務シーンを想定した5つのシナリオで、どちらの選択肢が適しているかを整理する。いずれも一般的な業務パターンからの想定シナリオであり、特定企業の実例ではない。
シナリオ1: グローバル展開するECサイトの注文管理システム
背景: 国内で稼働しているAurora MySQLベースの注文管理システムを、北米・欧州にも展開する計画がある。注文・在庫・決済のトランザクション整合性は絶対に崩せないが、各リージョンからの書き込みレイテンシも重視したい。
検討: マルチリージョンでの強一貫性トランザクションが必要なため、NewSQLが第一候補になる。すでにAWS上でAurora MySQLを使っており、AWSのサポート体制・請求を一本化したい事情があるなら、PostgreSQL互換への移行コストを許容できるかを見極めた上でAurora DSQLのマルチリージョンクラスタを検討する。一方、MySQL資産(ストアドプロシージャや既存のMySQL依存ツール)を多く抱えているなら、ワイヤプロトコル互換性の高いTiDBの方が移行コストを抑えられる可能性がある。いずれの場合も、注文確定処理を1トランザクションあたり数千行規模の一括更新にしない設計(注文明細ごとに分割するなど)が必要になる。
シナリオ2: マルチテナントSaaSのバックエンドDB
背景: BtoB SaaSでテナント数が急増しており、テナントごとのデータ量・アクセス頻度のばらつきが大きい。将来的にテナント単位でのシャーディングが必要になりそうだが、今は単一のAurora PostgreSQLクラスタで運用している。
検討: テナントIDを分散キーとして設計すれば、NewSQLへの移行でシャーディングの自前実装を回避できる。スキーマ変更(マイグレーション)の頻度が高いプロダクトフェーズであれば、DDL・DML分離やDDLの1トランザクション1文制約があるAurora DSQLよりも、より柔軟なマイグレーション運用ができるTiDBの方が開発速度への影響が小さい場合がある。ただし、テナントごとに複雑なレポーティングクエリ(分析用途)を提供する計画があるなら、TiFlashによるHTAP対応を持つTiDBが有利になる。
シナリオ3: 金融系の台帳(残高管理)システム
背景: ポイント残高やウォレット残高を管理するシステムで、二重引き落としや残高不整合は絶対に許容できない。トラフィックは特定商戦期(セール、キャンペーン)に集中してスパイクする。
検討: ACIDトランザクションと高可用性の両立が最優先事項であり、NewSQLの主戦場と言えるユースケースである。ただし、残高更新のような「同じ行に書き込みが集中する」アクセスパターンは、NewSQL全般が苦手とする「ホットスポット」問題を引き起こしやすい(特定のキー範囲・特定行への書き込みが集中すると、分散合意やOCCの競合検出のオーバーヘッドで性能が頭打ちになる現象。第三者による検証ブログでも指摘されている(Andrew Baker “Amazon Aurora DSQL: A Deep Dive into Performance and Limitations”)。対策として、残高更新を集計テーブルではなく「取引明細を追記し、残高は都度合算する」ようなイベントソーシング的な設計に寄せる、あるいはキー設計でランダム性を持たせて書き込みを分散させるといった工夫が必要になる。この設計変更を許容できない場合は、無理にNewSQLへ移行せず、従来型RDBMSでの垂直スケール+読み取りレプリカ構成の方が安全な場合もある。
シナリオ4: ゲームのリアルタイムランキング・インベントリ管理
背景: ソーシャルゲームで、プレイヤーのアイテムインベントリとランキングをリアルタイムに更新する必要がある。同時接続数が数十万規模で、レイテンシへの要求は非常に厳しい(体感で遅延を感じさせたくない)。
検討: 単純なキー値の読み書き(プレイヤーIDでのGet/Put)が中心で、複雑なJOINやマルチテーブルのトランザクションが少ないのであれば、NewSQLよりもDynamoDBのようなNoSQLの方が低レイテンシを実現しやすい。一方、アイテムの交換・トレード機能のように、複数プレイヤーの残高を同時に整合性を保って更新する必要がある機能だけを切り出してNewSQL(またはRDBMS)を併用する、というハイブリッド構成も現実的な選択肢になる。「全部NewSQLに寄せる」のではなく、機能ごとにデータストアを使い分ける発想が重要になるユースケースである。
シナリオ5: IoTセンサーデータの時系列蓄積と分析
背景: 工場の設備から秒単位で送られてくるセンサーデータを蓄積し、異常検知や月次レポートに使いたい。書き込みはほぼ追記のみで、更新・削除はほとんど発生しない。
検討: 追記中心で強いトランザクション整合性の要求が薄いワークロードは、NewSQLの強みである分散ACIDトランザクションをあまり活かせない。むしろ、DynamoDBやTimestream、あるいはS3+分析基盤(Athena等)といった時系列データに最適化されたサービスの方がコスト・性能の両面で有利になることが多い。NewSQLを選ぶとすれば、センサーデータそのものではなく「アラート発報時の状態管理」のように、整合性が重要な一部の機能に限定して採用するのが現実的である。
第7章 システム要件からの選定条件
これまでの整理を踏まえ、実際の技術選定で使えるチェックリスト形式の判断基準を示す。
7.1 判断基準の一覧
| # | チェック項目 | この条件に強く当てはまる場合 |
|---|---|---|
| 1 | 単一ノードRDBMSの書き込みスループットで今後2〜3年のトラフィック増加を吸収できるか | できる → 従来型RDBMSを維持。できない → NewSQL/NoSQLを検討 |
| 2 | マルチテーブルをまたぐACIDトランザクションが業務上必須か | 必須 → NewSQL(またはRDBMS)。不要 → NoSQLも選択肢 |
| 3 | マルチリージョンでの強一貫性(グローバルトランザクション)が要件にあるか | あり → NewSQL(特にAurora DSQLのマルチリージョンクラスタ、TiDBのマルチクラウド展開) |
| 4 | 1トランザクションで数千行規模の一括更新・バッチ処理が中核要件か | 該当 → Aurora DSQLの3,000行/トランザクション制約に抵触するため要注意。TiDBまたは従来型RDBMSを検討 |
| 5 | トリガー・ストアドプロシージャ・PostGIS等の拡張機能に強く依存しているか | 依存あり、かつ短期移行が必須 → Aurora DSQLは不向き。TiDBまたは移行スケジュールの見直しを検討 |
| 6 | 既存資産がMySQL系かPostgreSQL系か | MySQL系 → TiDBの方が移行障壁が低い。PostgreSQL系 → Aurora DSQLの方が移行障壁が低い |
| 7 | アクセスパターンが単純なキー値取得中心か、複雑なJOINを伴うか | キー値中心 → NoSQL(DynamoDB/Keyspaces)が有利。JOIN必須 → NewSQL/RDBMS |
| 8 | 特定行・特定キー範囲への書き込み集中(ホットスポット)が発生しやすい設計か | 発生しやすい → キー設計の見直しが前提。見直せないなら従来型RDBMSの方が安全な場合がある |
| 9 | 運用チームに分散データベースの専任知識(Raft、OCC等)があるか | ない → マネージドサービス(TiDB CloudまたはAurora DSQL)を前提にする。セルフホストTiDBは避ける |
| 10 | AWS単一クラウドへの依存を許容できるか、マルチクラウド/オンプレ展開の可能性があるか | AWS前提でよい → Aurora DSQL。マルチクラウドの可能性あり → TiDB |
| 11 | 分析(OLAP)クエリを同一システムで動かす必要があるか | 必要 → TiDB+TiFlashのHTAP構成を検討。不要 → どちらでも可 |
| 12 | コンプライアンス要件(FedRAMP等の認証)が specific に必要か | 必要 → 対象サービスの認証取得状況を公式情報で個別に確認(本記事執筆時点の情報は参考に留める) |
7.2 簡易フローとしての読み方
上記のうち、項目1〜3は「そもそもNewSQLというカテゴリを検討すべきか」の一次判定、項目4〜8は「NewSQLを選んだ場合に足元をすくわれる制約がないか」の二次チェック、項目9〜12は「TiDBかAurora DSQLか」の最終判断材料、という3段構成で読むと整理しやすい。
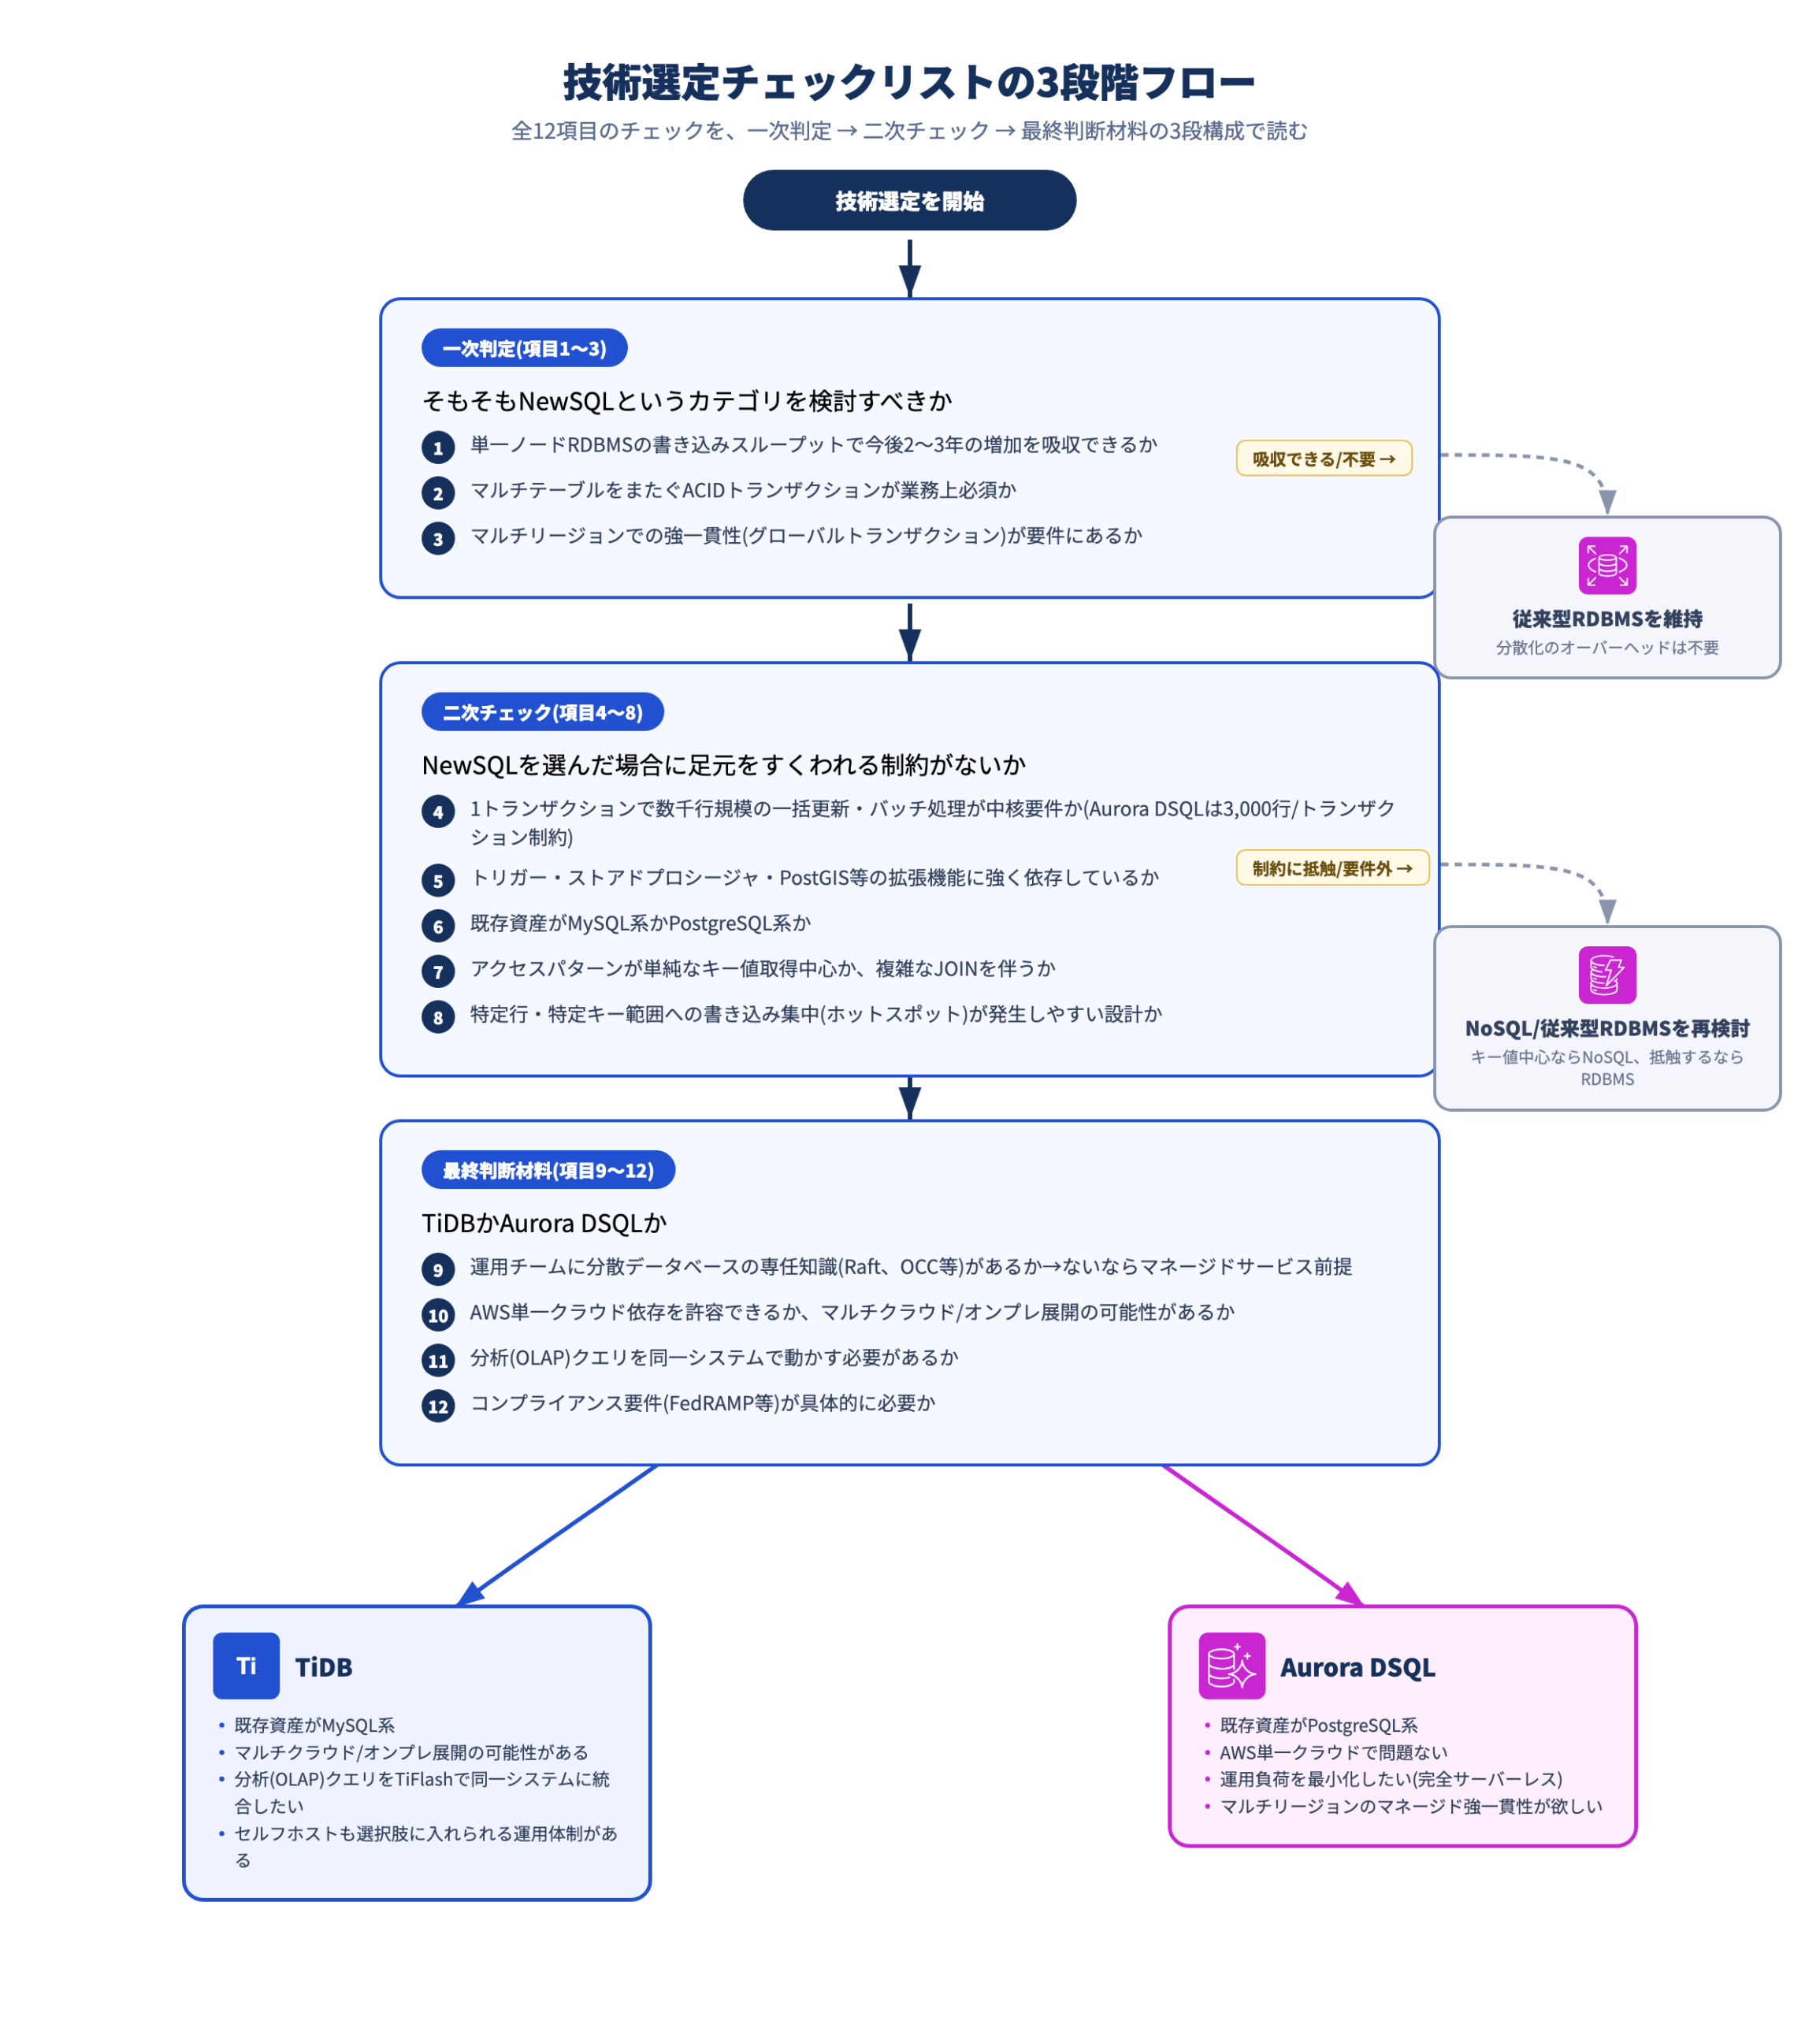
特に強調しておきたいのは、項目4・5・8のような「制約に抵触するとプロジェクトが詰む」タイプのチェックである。NewSQLの魅力的な謳い文句(水平スケール、強一貫性)に飛びつく前に、これらの制約を要件定義書と突き合わせる作業を、PoC(概念実証)の初期段階で必ず行うことを強く推奨する。
おわりに
TiDBというキーワードをきっかけに、NewSQLというカテゴリ、その代表例であるTiDBとAmazon Aurora DSQLの違いを整理した。両者は「SQL互換・ACIDトランザクション・水平スケール」という同じ理念を共有しつつも、対応プロトコル(MySQL系かPostgreSQL系か)、運用モデル(セルフホスト可能かフルマネージドのみか)、機能制約の中身が異なる、似て非なる製品である。
本記事は執筆時点(2026年9月)の情報に基づいている。特にAurora DSQLのような発展途上のマネージドサービスは機能追加のペースが速く、本稿で「未対応」とした項目が数ヶ月後には対応済みになっている可能性も十分にある。技術選定の際は、本記事を出発点としつつ、必ず各社の公式ドキュメントで最新情報を確認してほしい。
参考文献
- AWS Documentation: Migrating from PostgreSQL to Aurora DSQL
- AWS Documentation: Considerations for working with Amazon Aurora DSQL
- AWS What’s New: Amazon Aurora DSQL adds support for identity columns and sequence objects
- AWS Database Blog: Working with identity columns and sequences in Aurora DSQL
- AWS Documentation: Aurora DSQL region availability
- PingCAP Documentation: MySQL Compatibility
- Andrew Baker: Amazon Aurora DSQL — A Deep Dive into Performance and Limitations
- Yugabyte Blog: Aurora DSQL — How the Latest Distributed SQL Database Compares to YugabyteDB(競合製品ベンダーによる比較記事のため、評価は割り引いて読むことを推奨する)
AWS・エンジニアリングマネジメントの実務ネタを発信しています
コメント